
اجرای مدل Llama روی کامپیوتر؛ انتخاب Llama 3.2 و شروع گفتوگوی محلی
فهرست مطالب
- تفاوت Llama، llama.cpp و Ollama چیست؟
- کدام نسخهٔ Llama را انتخاب کنیم؟
- پیشنیازهای اجرای محلی
- اجرای مستقل Llama 3.2 با Ollama، مرحلهبهمرحله
- چه زمانی میتوان همان مدل را در HSTOCK AI HUB انتخاب کرد؟
- نمونهٔ عملی برای آزمون مدل
- خطاهای رایج هنگام اجرای Llama
- هزینه و مجوز: سه لایهٔ مستقل
- چه زمانی زیرساخت سازمانی لازم میشود؟
- جمعبندی
برای اجرای Llama روی کامپیوتر، باید یک نسخهٔ مجاز و دقیق از مدل Llama، یک موتور محلی مانند llama.cpp یا Ollama و حافظهٔ کافی داشته باشید. Llama نام خانوادهٔ مدلهای Meta است؛ با llama.cpp یا Ollama یکی نیست. در بررسی سورس HSTOCK AI HUB ۰٫۷۳٫۶۲، موتورهای محلی وجود داشتند اما هیچ رکورد مشخص Meta/Llama در کاتالوگ مدل پیدا نشد؛ بنابراین مسیر مستقیم «انتخاب Llama داخل HSTOCK» هنوز مستند نیست. این راهنما ابتدا اجرای مستقل رسمی Llama 3.2 را کامل میکند و سپس شرطهای لازم برای دیدهشدن آن در HSTOCK را توضیح میدهد.
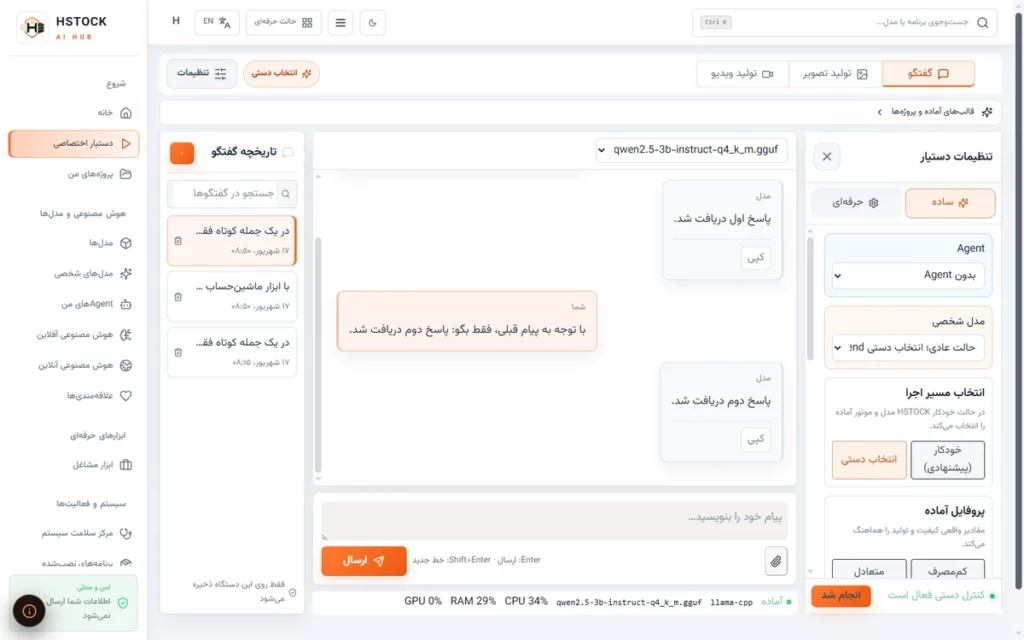
مرز نسخه: مسیر عمومی موتور و انتخاب مدل از سورس پیشانتشار HSTOCK AI HUB ۰٫۷۳٫۶۲ مستند شده است، نه یک مدل Llama آماده. صفحهٔ عمومی در مشاهدهٔ ثبتشدهٔ ۷ نوامبر ۲۰۲۶ نسخهٔ ۰٫۷۳٫۳۹ را عرضه میکرد و یکسانبودن قابلیتها تأیید نشده است. تصویر رابط نیز آرشیوی و مربوط به ۰٫۶۷٫۱ است.
تفاوت Llama، llama.cpp و Ollama چیست؟
| نام | چیست؟ | مجوز |
|---|---|---|
| Llama | خانوادهٔ مدلهای زبانی Meta | شرایط اختصاصی هر نسل؛ برای نمونه Llama 3.2 Community License |
| llama.cpp | موتور سبک اجرای مدلهای سازگار، معمولاً در قالب GGUF | MIT برای خود موتور |
| Ollama | موتور و مدیر مدل با API محلی و مسیر ابری جدا | MIT برای خود موتور؛ مجوز مدل جداست |
| HSTOCK AI HUB | رابط انتخاب موتور، مدل و گفتوگو | مجوز برنامه مستقل از سه مورد بالاست |
این تفکیک جلوی یک اشتباه رایج را میگیرد: نصب llama.cpp به معنی دریافت Llama نیست و داشتن فایل با پسوند GGUF نیز بهتنهایی سازگاری آن با هر موتور یا هر نسخه را ثابت نمیکند.
کدام نسخهٔ Llama را انتخاب کنیم؟
انتخاب را از نیاز شروع کنید، نه از بزرگترین عدد پارامتر. برای گفتوگوی روزمره روی یک کامپیوتر معمولی، مدل کوچکتر و کوانتیزه اغلب واقعبینانهتر است. برای متن طولانی، برنامهنویسی یا چند کاربر همزمان، حافظه و زمان پردازش اهمیت بیشتری پیدا میکند. نام مدل، اندازهٔ فایل، نوع کوانتیزه، طول زمینه و زبانهای پشتیبانیشده را روی صفحهٔ همان مدل بخوانید.
برای مقایسهٔ Q4، Q5 و Q8 و بررسی سازگاری فایل با موتور، راهنمای انتخاب فایل GGUF و کوانتیزه را بخوانید.
برای مثال، کارت رسمی Llama 3.2 مدلهای متنی ۱B و ۳B را معرفی میکند، اما فارسی را در فهرست زبانهای رسماً پشتیبانیشدهٔ آن نسل نمیآورد. بنابراین میتوان فارسی را آزمایش کرد، ولی نباید کیفیت فارسی را از روی نام Llama تضمینشده دانست.
| انتخاب این راهنما | tag در Ollama | مناسب برای | محدودیت تصمیم |
|---|---|---|---|
| Llama 3.2 متن ۱B | llama3.2:1b | آزمون سبکتر و سنجش اولیهٔ دستورهای کوتاه | اندازهٔ کمتر، کیفیت یا فارسی بهتر را تضمین نمیکند. |
| Llama 3.2 متن ۳B | llama3.2 یا tag صریح ۳B در صفحهٔ رسمی | نمونهٔ اصلی گفتوگوی این مقاله | تعداد پارامتر، حداقل RAM/VRAM یا سرعت واقعی دستگاه را تعیین نمیکند. |
نام کامل خانواده، گونهٔ متنی و tag را همراه نتیجهٔ آزمون ثبت کنید. عبارت «Llama 3.2» بهتنهایی برای بازتولید کافی نیست و این راهنما ادعا نمیکند که این نسل جدیدترین Llama است.
پیشنیازهای اجرای محلی
- برای مسیر مستقل این مقاله، HSTOCK AI HUB لازم نیست؛ یک موتور نصب و قابل اجرا مانند Ollama کافی است. نسخهٔ HSTOCK فقط برای بخش اختیاری اتصال به برنامه مطرح میشود.
- فایل مدل سازگار و کامل. برای llama.cpp معمولاً GGUF لازم است؛ برای Ollama باید مدل در فهرست خود Ollama آماده باشد.
- RAM/VRAM و فضای دیسک متناسب با همان فایل. از روی نام 3B یا 8B بهتنهایی نمیتوان مصرف دقیق را تعیین کرد.
- بررسی مجوز و صفحهٔ رسمی مدل پیش از استفادهٔ سازمانی، بازتوزیع یا ساخت محصول.

اجرای مستقل Llama 3.2 با Ollama، مرحلهبهمرحله
برای داشتن یک مسیر قابلتکرار و مستند، از Ollama و tag رسمی Llama 3.2 شروع کنید. این مسیر مستقل است و به معنی اتصال خودکار به HSTOCK نیست.
- Ollama برای ویندوز را از منبع رسمی نصب کنید. نیازمندیهای سیستم را پیش از دانلود بخوانید.
- کارت رسمی Llama 3.2 و مجوز جامعهٔ Llama 3.2 را بررسی کنید.
- PowerShell تازه باز کنید و فرمان زیر را اجرا کنید. این tag در کتابخانهٔ رسمی Ollama برای مدل متنی Llama 3.2 معرفی شده است.
ollama run llama3.2- پس از دریافت مدل، یک پرسش کوتاه بفرستید. با
/byeاز گفتگو خارج شوید. - در اجرای بعدی همان فرمان را تکرار کنید و مطمئن شوید مدل بدون دریافت دوباره باز میشود. این فقط آمادگی مسیر مستقل Ollama را نشان میدهد.
- پرسش آزمایشی فارسی پایین را اجرا و کیفیت واقعی را بررسی کنید؛ فارسی در فهرست زبانهای رسماً پشتیبانیشدهٔ کارت Llama 3.2 نیست.
چه زمانی میتوان همان مدل را در HSTOCK AI HUB انتخاب کرد؟
سورس ۰٫۷۳٫۶۲ مسیر عمومی ورود GGUF و انتخاب tag واقعی Ollama را دارد، اما در بررسی فعلی هیچ رکورد صریح Meta/Llama یا رسید اجرای یک Llama مشخص پیدا نشد. نبود این رکورد بهتنهایی پشتیبانینشدن همهٔ مسیرها را ثابت نمیکند؛ در عین حال، وجود مسیر عمومی نیز سازگاری معماری، شناسه، مجوز یا بارگیری موفق مدل شما را ثابت نمیکند. بنابراین مدل مستقل llama3.2 را خودسرانه معادل یک مدل HSTOCK با نام دیگر ندانید و فقط پس از مشاهدهٔ مدل دقیق و یک اجرای واقعی در نسخهٔ خود، اتصال را تأییدشده تلقی کنید.
- نسخه و راهنمای HSTOCK خود را بررسی کنید. صفحهٔ عمومی ۰٫۷۳٫۳۹ وجود این اتصال را ثابت نمیکند.
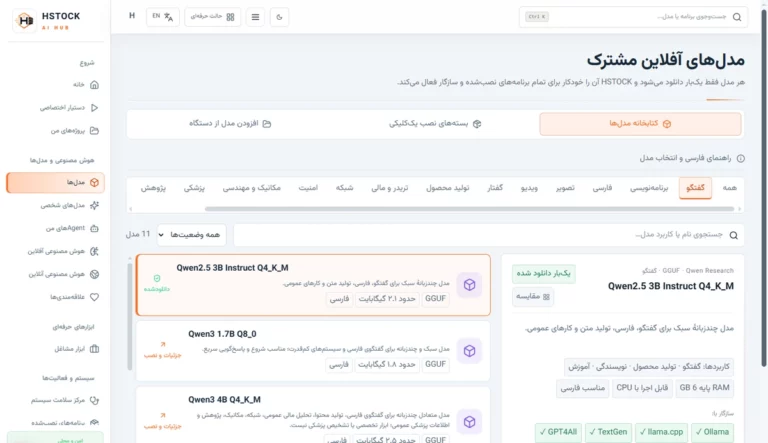
- در کتابخانه یا فهرست موتور، نام دقیق مدل/tag، منبع، مجوز و سازگاری فایل را بررسی کنید. نبود رکورد کاتالوگ صریح فقط یعنی مسیر کاتالوگ در این بررسی احراز نشده است؛ مسیر دیگری را نیز بدون شاهد موفق فرض نکنید.
- تنها اگر شناسهٔ واقعی دیده شد و بارگیری موفق بود، در «دستیار اختصاصی» موتور و همان شناسهٔ دقیق را انتخاب کنید.
- یک پرسش کوتاه بفرستید و نام مدل ثبتشده در رابط را همراه نتیجه نگه دارید. کیفیت پاسخ بهتنهایی مدرک هویت مدل نیست.
اگر میخواهید موتور را مستقل بررسی کنید، مخزن رسمی llama.cpp و راهنمای نصب آن را بخوانید. این راهنما جایگزین مسیر مدیریتشدهٔ HSTOCK نیست و نصب جداگانه ممکن است خودکار شناسایی نشود.
نمونهٔ عملی برای آزمون مدل
یک برنامهٔ سهمرحلهای برای مرتبکردن پوشههای کاری پیشنهاد بده. پاسخ را فارسی، کوتاه و بدون ادعای دسترسی به فایلهای من بنویس.در پاسخ بررسی کنید آیا مدل واقعاً سه مرحله داده، محدودیت دسترسی را رعایت کرده و فارسی قابلفهم نوشته است. سپس یک سؤال پیگیری مانند «مرحلهٔ دوم را با مثال توضیح بده» بفرستید تا حفظ زمینهٔ همان گفتوگو را ببینید. این یک آزمون کاربردی کوچک است، نه بنچمارک سرعت، دقت یا امنیت.
خطاهای رایج هنگام اجرای Llama
| مشکل | معنی محتمل | راه بررسی |
|---|---|---|
| مدل در فهرست دیده نمیشود | فایل کامل نیست، فرمت با موتور سازگار نیست یا هنوز فعال نشده است. | نام فایل، پسوند، منبع و وضعیت آمادهبودن مدل را در کتابخانه بررسی کنید. |
| llama.cpp اجرا میشود اما پاسخ نمیآید | قالب گفتوگو، مدل انتخابی یا حافظه مشکل دارد. | با درخواست کوتاهتر و مدل کوچکتر شروع کنید؛ پیام خطای مرکز سلامت را نگه دارید. |
| پاسخ فارسی ضعیف است | فارسی در مدل انتخابی بهخوبی پشتیبانی نشده یا کوانتیزه/اندازه روی کیفیت اثر گذاشته است. | کارت مدل را بخوانید و چند نمونهٔ واقعی خودتان را مقایسه کنید. |
| برنامه کند یا سیستم بیپاسخ میشود | مدل یا طول زمینه برای RAM/VRAM دستگاه سنگین است. | مدل کوچکتر، زمینهٔ کوتاهتر یا مسیر CPU/GPU مناسبتر را انتخاب کنید. |
| فایل GGUF باز نمیشود | فایل ناقص، معماری نامعتبر یا نسخهٔ موتور ناسازگار است. | هش/حجم منبع را کنترل و نسخهٔ موتور را با مستندات همان فایل تطبیق دهید. |
هزینه و مجوز: سه لایهٔ مستقل
- موتور: llama.cpp و Ollama برای کد خود مجوز MIT دارند.
- مدل: برای نمونه، Llama 3.2 تحت مجوز جامعهٔ Llama 3.2 است؛ این مجوز با MIT یکی نیست و برای بازتوزیع و کاربردهای خاص شرط دارد.
- برنامه: HSTOCK AI HUB طبق اعلام سازنده رایگان است، اما مجوز و شرایط خودش را دارد. رایگانبودن برنامه به معنی آزادبودن مدل یا حذف هزینهٔ سختافزار نیست.
پس از دریافت اجزا، اجرای محلی معمولاً API پولی لازم ندارد. اما اگر مسیر ابری، سرویس آنلاین، جستوجوی وب یا مدل میزبانیشده را فعال کنید، اینترنت و هزینهٔ آن سرویس جداست. برای حفظ دادهٔ حساس نیز فقط به برچسب «محلی» اکتفا نکنید؛ تنظیمات وب، ابزارها و مقصد فایلها را جدا کنترل کنید.
چه زمانی زیرساخت سازمانی لازم میشود؟
برای یک کاربر و مدل کوچک Llama، کامپیوتر شخصی مناسب میتواند کافی باشد و خرید سرور الزامی نیست. اگر چند کاربر همزمان، مدلهای بزرگ یا نگهداری متمرکز مطرح است، باید RAM، GPU، توان و محدودیت مجوز مدل اندازهگیری شود. در صورت نیاز واقعی به زیرساخت رکمونت، دستهٔ خرید سرور HP نقطهای برای بررسی پیکربندیهاست؛ سازگاری نهایی به قطعات دقیق وابسته است، نه صرف نام سرور.
جمعبندی
اجرای مستقل Llama 3.2 با Ollama مسیر مستند این مقاله است. برای استفاده از همین خانوادهٔ مدل در HSTOCK، باید مدل یا tag دقیق و سازگار، مجوز روشن و بارگیری موفق در همان نسخه تأیید شود؛ اجرای یک Llama مشخص در برنامه برای این راهنما هنوز تأیید نشده است. برای نصب عمومی موتور، مقالهٔ دانلود هوش مصنوعی آفلاین برای ویندوز را بخوانید؛ برای کار با اسناد شخصی، راهنمای دستیار هوش مصنوعی با فایلهای خودمان موضوع جداگانهای را پوشش میدهد.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. اولین نفر باشید.