
ساخت مدل هوش مصنوعی با دادههای خودمان؛ انتخاب روش و آمادهسازی دیتاست
فهرست مطالب
- کدام روش برای دادههای شما مناسب است؟
- پیش از جمعآوری داده، کار مدل را دقیق بنویسید
- داده خام را به نمونه قابلاعتماد تبدیل کنید
- پاکسازی فقط حذف ردیف خالی نیست
- مثال ساختگی: آمادهکردن داده برای دستهبندی درخواست پشتیبانی
- نمونه را در چه فرمتی ذخیره کنیم؟
- نمونههای یادگیری و داده آزمون را جدا نگه دارید
- مدل پایه را با همان کار واقعی انتخاب کنید
- بهترشدن را چگونه بسنجیم؟
- Dataset Studio در HSTOCK AI HUB چه کاری انجام میدهد؟
- خروجی دیتاست با فایل مدل آموزشدیده فرق دارد
- اگر واقعاً به Fine-tuning یا LoRA نیاز داشتیم
- هزینه و سختافزار را پس از انتخاب روش بررسی کنید
- خطاهای رایج و اقدام بعدی
- پرسشهای متداول
- برای ساخت مدل شخصی چند نمونه لازم است؟
- میتوانیم فایل PDF را به دیتاست تبدیل کنیم؟
- آیا دادههای ما با واردکردن در Dataset Studio داخل وزن مدل ذخیره میشوند؟
- از کجا بفهمیم پروژه آماده استفاده است؟
میخواهید هوش مصنوعی از فایلها پاسخ بگیرد یا درخواستهای پشتیبانی را به شکل دلخواه شما دستهبندی کند؟ برای ساخت هوش مصنوعی با دادههای خودتان، اول مشخص کنید چه چیزی باید بهتر شود: دسترسی به اطلاعات اختصاصی، شکل پاسخ یا توانایی انجام یک کار مشخص. افزودن چند فایل یا نمونه پاسخ، همیشه به معنی آموزش وزنهای مدل نیست. گاهی یک دستور روشن یا بازیابی اطلاعات از اسناد کافی است؛ گاهی هم آموزش تکمیلی یک مدل موجود ارزش بررسی دارد.
در این راهنما، مسیر را از تعریف مسئله تا آمادهکردن دیتاست، جداکردن داده آزمون، انتخاب مدل و سنجیدن نتیجه طی میکنیم. دیتاست یعنی مجموعهای ساختاریافته از نمونهها؛ در اینجا هر نمونه شامل درخواست و پاسخ مطلوب است و در صورت نیاز، زمینهای هم کنار آن قرار میگیرد. هدف، آمادهکردن دادهای قابلبررسی است، نه وعده ساخت یک مدل عمومی با چند کلیک.
اگر فقط میخواهید از PDF و فایلهای موجود سؤال بپرسید، راهنمای ساخت دستیار با اسناد خودتان مسیر مستقیمتری دارد. تمرکز این مقاله روی نمونههای پاسخ، کیفیت داده و ارزیابی روشی است که برای شخصیسازی انتخاب میکنید.
کدام روش برای دادههای شما مناسب است؟
| روش | چه چیزی تغییر میکند؟ | چه زمانی بررسی شود؟ |
|---|---|---|
| دستور و چند مثال در ورودی | متنی که هنگام پاسخگویی به مدل میدهید؛ وزنها تغییر نمیکنند. | وقتی رفتار مطلوب را میتوان با دستور کوتاه و چند مثال روشن نشان داد. |
| بازیابی از اسناد یا RAG | بخشهای مرتبط اسناد به ورودی مدل اضافه میشوند. | وقتی پاسخ باید به اطلاعات مشخص، قابلارجاع یا بهروزشونده تکیه کند. |
| نمونههای بازیابیشده در زمان پاسخ | نمونههای مرتبط از مجموعه مثالها در اختیار مدل قرار میگیرند. | وقتی میخواهید شکل پاسخ را با مثال نشان دهید؛ این مسیر در Dataset Studio بررسیشده، آموزش وزنها نیست. |
| آموزش تکمیلی یا Fine-tuning | مدل از یک نسخه ازپیشآموزشدیده شروع میکند و در یک فرایند آموزشی تغییر میکند. | وقتی بعد از سنجیدن روش سادهتر، برای یک وظیفه مشخص هنوز خطاهای تکرارشونده دارید. |
| آموزش با LoRA | پارامترهای کوچک افزودهشده آموزش میبینند و وزنهای اصلی ثابت میمانند. | وقتی روش، مدل پایه، ابزار آموزشی و سختافزار از این شیوه پشتیبانی میکنند. |
| آموزش از صفر | پارامترهای مدل از ابتدا آموزش داده میشوند. | برای مسئلهای که واقعاً به طراحی و آموزش مدل نیاز دارد؛ ساخت یک مدل زبانی عمومی از صفر، پروژهای متفاوت از شخصیسازی دستیار است. |
طبق راهنمای Fine-tuning در Hugging Face، آموزش تکمیلی از مدل ازپیشآموزشدیده شروع میشود. توضیح رسمی LoRA هم ثابتماندن وزنهای اصلی و آموزش پارامترهای افزوده را شرح میدهد. اتصال فایل LoRA آماده به یک برنامه، با اجرای این فرایند آموزشی فرق دارد.
برای مثال، مقرراتی که مرتب تغییر میکنند بهتر است در منبعی قابلبهروزرسانی نگهداری شوند. اگر مسئله شما قالب ثابت یک گزارش است، ابتدا دستور و مثال را امتحان کنید. ممکن است در یک پروژه، بازیابی اسناد و آموزش تکمیلی در کنار هم قرار بگیرند؛ انتخاب آنها باید از نوع خطا و نتیجه ارزیابی بیاید.
پیش از جمعآوری داده، کار مدل را دقیق بنویسید
جمله «یک هوش مصنوعی برای شرکت میخواهیم» معیار روشنی ندارد. آن را به کاری قابلسنجش تبدیل کنید؛ مثلاً «درخواست پشتیبانی را در یکی از دستههای تعریفشده قرار دهد و فقط اطلاعات ضروریِ گمشده را بپرسد». مشخص کنید ورودی چیست، خروجی باید چه شکلی داشته باشد و مدل کجا باید اعلام کند اطلاعات کافی نیست.
- کار مجاز: یک وظیفه روشن با خروجی مشخص، مانند دستهبندی درخواست یا بازنویسی یک متن در قالب معین.
- کار خارج از دامنه: مواردی که مدل نباید درباره آنها پاسخ قطعی بدهد یا اطلاعات تازه بسازد.
- پاسخ مطلوب: نمونهای که یک بازبین بتواند درستی و کاملبودن آن را توضیح دهد.
- معیار پذیرش: دسته درست، رعایت قالب، حفظ عددها و نامها، پرسیدن سؤال لازم و خودداری از حدس بیپشتوانه.
اگر دو بازبین بر سر پاسخ درست اختلاف دارند، ابتدا راهنمای کار را روشن کنید. زیادکردن نمونههای متناقض، ابهام تعریف مسئله را برطرف نمیکند.

داده خام را به نمونه قابلاعتماد تبدیل کنید
ایمیلها، گفتوگوها و فایلهای قدیمی لزوماً نمونه مناسب نیستند. پاسخ یک کارشناس ممکن است به اطلاعاتی بیرون از همان مکالمه وابسته باشد یا بعداً اصلاح شده باشد. برای هر نمونه، درخواست را همراه زمینه لازم و پاسخ بازبینیشده نگه دارید؛ پاسخ اولیهای که صرفاً زودتر ثبت شده، مرجع قطعی نیست.
| اطلاعات همراه داده | چرا نگهداری شود؟ |
|---|---|
| شناسه نمونه و گروه آن | تا نمونه، مکالمه یا پرونده مرتبط را دوباره پیدا کنید و آنها را میان مجموعههای ارزیابی پخش نکنید. |
| منبع و تاریخ یا نسخه | تا پاسخ وابسته به دستورالعمل قدیمی با پاسخ نسخه تازه مخلوط نشود. |
| درخواست، زمینه و پاسخ مطلوب | تا معلوم باشد مدل چه ورودیای میبیند و پاسخ باید بر چه اطلاعاتی تکیه کند. |
| مجوز استفاده و وضعیت داده حساس | تا معلوم باشد حق استفاده، پردازش و در صورت نیاز انتشار این داده را دارید. |
| وضعیت بازبینی و دلیل تغییر | تا تأیید انسانی، اختلاف نظر و اصلاح بعدی قابلپیگیری باشد. |
لازم نیست همه این اطلاعات داخل ورودی مدل قرار بگیرند؛ بخشی از آنها دفتر ثبت داده شما هستند. راهنمای کارت دیتاست نیز ثبت محتوای مجموعه، کاربرد، محدودیت و اطلاعاتی مانند زبان و مجوز را توضیح میدهد. داشتن فایل روی کامپیوتر، بهتنهایی حق آموزش یا انتشار آن را ثابت نمیکند.
پاکسازی فقط حذف ردیف خالی نیست
- اطلاعات غیرضروری و محرمانه را کنار بگذارید. برای یاددادن قالب پاسخ، معمولاً به شماره تماس واقعی، رمز یا مشخصات مشتری نیاز ندارید. پس از حذف اطلاعات شناساییکننده، دوباره بررسی کنید که نمونه هنوز مفهوم درستی داشته باشد.
- متن را خوانا کنید و معنی را حفظ کنید. فاصلهها و نویسههای ناهماهنگ فارسی را یکدست کنید، اما شماره مدل، شناسه خطا، واحد و مقدار عددی را بیدلیل تغییر ندهید.
- تکرارها را در سطح معنا هم ببینید. دو جمله با نگارش متفاوت ممکن است یک درخواست یا یک پرونده باشند. تشخیص تکرار عیناً یکسان، همه این موارد را پیدا نمیکند.
- تعارض را حل کنید. برای یک درخواست و زمینه یکسان، دو پاسخ ناسازگار را همزمان پاسخ مطلوب ندانید. اگر پاسخ به تاریخ، نقش کاربر یا نسخه محصول وابسته است، همان شرط را در زمینه روشن کنید.
- فقط نمونه آسان جمع نکنید. درخواست ناقص، سؤال خارج از دامنه، غلط املایی و تغییر خواسته در ادامه گفتگو هم بخشی از کار واقعیاند. پاسخ مرجع این موارد را با دقت بازبینی کنید.
- داده تولیدشده با مدل را بازبینی کنید. متن روان میتواند نادرست باشد. نمونه مصنوعی را با همین عنوان ثبت کنید و آن را شاهد تجربه واقعی مشتری یا نتیجه آزمون عملی معرفی نکنید.
هنگام آمادهکردن دیتاستِ مدل شخصی، با مجموعهای کوچک و متنوع شروع کنید و همهٔ نمونههایش را بخوانید. پیش از افزودن هر ردیف بپرسید: «این نمونه کدام وضعیت تازه را پوشش میدهد؟» تعداد بیشتر وقتی مفید است که پوشش مسئله بهتر شود؛ تغییر چند کلمه در یک سؤال، جای نمونهٔ تازه و معتبر را نمیگیرد.
مثال ساختگی: آمادهکردن داده برای دستهبندی درخواست پشتیبانی
تمام دادهها و پاسخهای این مثال ساختگیاند. اینها اطلاعات مشتری یا گزارش اجرای برنامه نیستند. فرض میکنیم تیمی سه دسته «چاپ»، «دسترسی فایل» و «نامشخص» تعریف کرده است. خروجی مطلوب دو بخش دارد: دسته پیشنهادی و یک سؤال بعدی؛ مدل نباید علت قطعی خرابی را از روی اطلاعات ناکافی بسازد.
| درخواست ساختگی | پاسخ مطلوب در همین مثال | اشتباهی که باید پیدا شود |
|---|---|---|
| چاپگر شبکه دیده نمیشود؛ بقیه شبکه کار میکند. | دسته: چاپ. سؤال بعدی: نام چاپگر و متن خطای نمایشدادهشده چیست؟ | اعلام قطعی خرابی چاپگر یا پیشنهاد تغییر تنظیمات بدون شواهد. |
| برای ورود به پوشه مشترک پیام Access denied میآید. | دسته: دسترسی فایل. سؤال بعدی: این خطا برای همه کاربران رخ میدهد یا فقط یک حساب؟ | درخواست رمز کاربر یا فرض قطعی درباره مجوزها. |
| برنامه باز نمیشود. | دسته: نامشخص. سؤال بعدی: نام برنامه و متن خطا چیست؟ | انتخاب اجباری یک دسته با اطلاعات ناکافی. |
این سه ردیف فقط شکل کار را نشان میدهند و برای اثبات کیفیت یا کافیبودن دیتاست نیستند. در پروژه واقعی، دستهها و پاسخ مطلوب را از کار واقعی و با نظر مسئول همان فرایند تعریف کنید.
نمونه را در چه فرمتی ذخیره کنیم؟
برای ویرایش اولیه، یک جدول ساده کافی است. برای جابهجایی میان ابزارها، JSONL گزینهای قابلبررسی است: هر خط یک شیء JSON کامل است. در فایل واقعی، توضیح بیرون از ساختار JSON ننویسید و هر نمونه را در یک خط نگه دارید. فایل را با کدگذاری UTF-8 ذخیره کنید تا متن فارسی حفظ شود.
نمونهٔ زیر قالب ورودیِ تعریفشده در کد نسخهٔ آزمایشی ۰٫۷۳٫۶۲ را نشان میدهد. در این مثال، مقدار status را draft گذاشتهایم تا نمونه بعداً بازبینی شود. این متن، خروجی اجرای برنامه نیست:
{"instruction":"چاپگر شبکه دیده نمیشود؛ بقیه شبکه کار میکند.","input":"دستههای مجاز: چاپ، دسترسی فایل، نامشخص. پاسخ شامل دسته و یک سؤال بعدی باشد.","output":"دسته: چاپ. سؤال بعدی: نام چاپگر و متن خطای نمایشدادهشده چیست؟","tags":["چاپ","نمونه-ساختگی"],"status":"draft","sourceName":"مثال ساختگی این مقاله"}
{"instruction":"برنامه باز نمیشود.","input":"دستههای مجاز: چاپ، دسترسی فایل، نامشخص. پاسخ شامل دسته و یک سؤال بعدی باشد.","output":"دسته: نامشخص. سؤال بعدی: نام برنامه و متن خطا چیست؟","tags":["ورودی-ناقص","نمونه-ساختگی"],"status":"draft","sourceName":"مثال ساختگی این مقاله"}| فرمت | نکته کاربردی در Dataset Studio بررسیشده |
|---|---|
| JSONL و JSON | فیلدهای instruction، input و output یا نامهای پذیرفتهشده هممعنی خوانده میشوند. برای تعیین وضعیت بازبینی، نمونه بالا از status استفاده میکند. |
| CSV و TSV | ستونهای درخواست، زمینه و پاسخ خوانده میشوند؛ برای جلوگیری از جابهجایی ستونها، نقلقول و جداکنندهها را بررسی کنید. یک فایل کوچک را پیش از مجموعه اصلی بازبینی کنید. |
| TXT و Markdown | جفتهای مشخص سؤال و پاسخ قابلخواندناند؛ یک متن بلندِ بدون مرز نمونه، معادل دیتاست پرسشوپاسخ نیست. |
| قالب messages یا conversations | در تبدیل بررسیشده، آخرین پیام کاربر و آخرین پاسخ دستیار انتخاب میشوند؛ حفظ کامل مکالمه چندمرحلهای را فرض نکنید. |
قالب ورودی ابزارهای آموزش یکسان نیست. برای نمونه، مستندات SFT Trainer چند قالب از جمله متن، درخواست و پاسخ، و پیامهای گفتوگویی را معرفی میکند. قابلخواندنبودن JSONL در یک برنامه به معنی آمادهبودن آن برای هر ابزار آموزشی یا هر مدل نیست؛ قالب گفتوگو، طول ورودی و روش آمادهسازی متن باید با ابزار مقصد تطبیق داده شوند.
نمونههای یادگیری و داده آزمون را جدا نگه دارید
اگر همان مثالهایی را بپرسید که در اختیار مدل گذاشتهاید، نتیجه برای سنجیدن برخورد با درخواست تازه کافی نیست. این مسئله در آموزش تکمیلی و در استفاده از نمونههای بازیابیشده اهمیت دارد. دادهای که قرار است آزمون نهایی باشد نباید از قبل بهعنوان مثال پاسخگویی وارد Dataset Studio شود.
| بخش داده | کاربرد | قاعده پیشنهادی |
|---|---|---|
| نمونههای آموزش یا مثالهای قابلاستفاده | برای یاددادن الگو یا ارائه مثال هنگام پاسخ. | فقط موارد بازبینیشده و متناسب با کار را وارد این بخش کنید. |
| مجموعه تنظیم و بازبینی | برای انتخاب دستور، مدل و تنظیمات و پیداکردن خطاها. | نتیجه این بخش را برای اصلاح روش به کار ببرید؛ آن را نتیجه آزمون نهایی ننامید. |
| مجموعه آزمون نهایی | برای سنجیدن نسخه انتخابشده روی موارد کنارگذاشتهشده. | تا زمان ارزیابی نهایی وارد چرخه اصلاح روزمره نکنید؛ موارد مرتبط و تکراری را جداگانه کنترل کنید. |
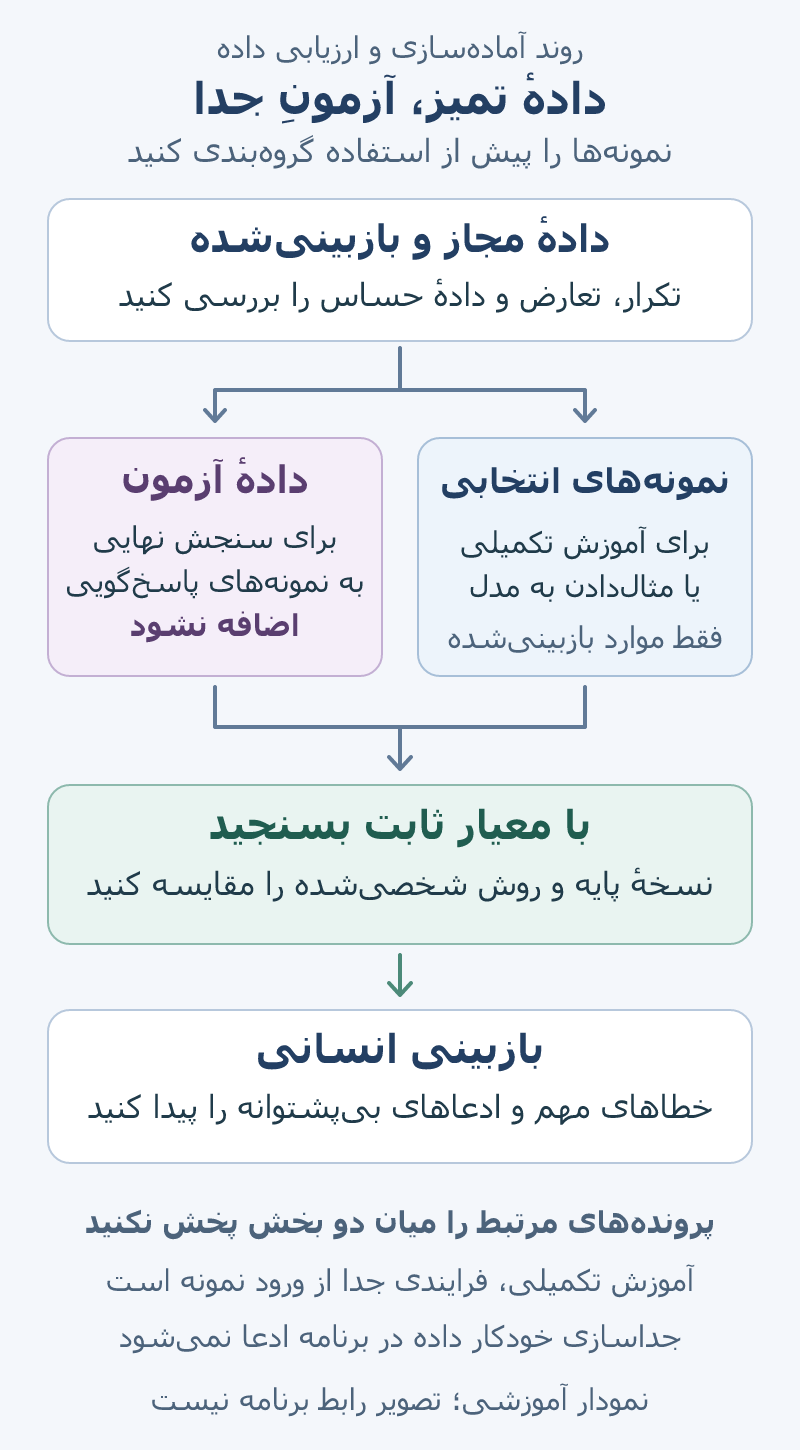
برای جلوگیری از نشت داده، پیامهای یک پرونده و بازنویسیهای نزدیک آن را در یک گروه نگه دارید. اگر آموزش از یک پرونده و آزمون از همان پرونده با جملهای کمی متفاوت باشد، ارزیابی میتواند بیش از واقع امیدوارکننده به نظر برسد. برای دادهای که با گذشت زمان تغییر میکند، جداکردن نسخهها و بازههای زمانی را هم بررسی کنید.
نسبت ثابت و مناسبی برای همه پروژهها وجود ندارد؛ مهم است در هر بخش، نمونه کافی از کارهای مهم داشته باشید. راهنمای تقسیم داده در Hugging Face Datasets روش ساخت مجموعههای جدا را توضیح میدهد. گروهبندی پروندهها و کنارگذاشتن دادهٔ آزمون را خودتان انجام دهید؛ انجام خودکار این جداسازی در Dataset Studio تأیید نشده است.
مدل پایه را با همان کار واقعی انتخاب کنید
مدلی که پاسخ عمومی روانی دارد، لزوماً در دستهبندی درخواست فارسی یا رعایت قالب شما بهترین انتخاب نیست. پیش از آموزش تکمیلی، یک نسخه پایه با دستور ثابت و بدون نمونههای اختصاصی بسنجید. سپس ببینید افزودن مثال یا بازیابی، کدام خطا را کم کرده است. اگر روش سادهتر مسئله را حل میکند، دلیل روشنی برای پیچیدهترکردن مسیر ندارید.
- زبان و کاربرد: چند ورودی واقعیِ مجاز، اصطلاح تخصصی و متن فارسی را با همان معیار بررسی کنید.
- مجوز: مجوز مدل پایه، داده و در صورت وجود Adapter را جدا بخوانید؛ رایگانبودن دریافت فایل، مجوز نامحدود استفاده تجاری نیست.
- سازگاری: قالب مدل، موتور اجرا و ابزار آموزش باید با هم سازگار باشند؛ فایل مناسب اجرا الزاماً ورودی آماده آموزش نیست.
- طول ورودی: درخواست، زمینه و پاسخ باید در محدودیت مدل و ابزار جا بگیرند؛ بخش حذفشده از ورودی میتواند معنی نمونه را عوض کند.
- امکان تکرار بررسی: نام دقیق مدل، نسخه فایل، دستور، تنظیمات و نسخه دیتاست را ثبت کنید تا دو نتیجه قابلمقایسه باشند.
کارت مدل در Hugging Face محل مناسبی برای خواندن کاربرد، محدودیتها، اطلاعات آموزش و نتایج ارزیابی اعلامشده است. نتیجه منتشرشده برای یک آزمون عمومی، جای بررسی روی داده و دستگاه شما را نمیگیرد.

بهترشدن را چگونه بسنجیم؟
نسخهٔ پایه و نسخهٔ شخصیشده را با سؤالهای یکسان از مجموعهٔ آزمون مقایسه کنید. مدل پایه، دستور و تنظیمات را تا جایی که میشود ثابت نگه دارید و هر تفاوت را ثبت کنید. جدول زیر پیشنهاد میکند چه چیزهایی را بسنجید؛ نتیجهٔ آزمون انجامشده نیست:
| نوع سؤال | چه چیزی بررسی شود؟ |
|---|---|
| درخواست معمولی | آیا دسته و قالب پاسخ درست است و اطلاعات لازم از ورودی حفظ شدهاند؟ |
| جمله تازه با همان نیاز | آیا مدل معنی را میفهمد یا صرفاً پاسخ یک عبارت آشنا را تکرار میکند؟ |
| اطلاعات ناقص | آیا سؤال لازم را میپرسد و از نتیجهگیری قطعی پرهیز میکند؟ |
| درخواست خارج از دامنه | آیا محدودیت کار را روشن میگوید و خروجی بیپشتوانه نمیسازد؟ |
| داده دارای عدد، نام یا شناسه | آیا مقدارها و شناسهها را بدون تغییر نادرست حفظ میکند؟ |
| اطلاعات متعارض یا قدیمی | آیا نیاز به روشنشدن زمینه یا نسخه منبع را تشخیص میدهد؟ |
برای دستهبندی میتوانید تعداد پاسخهای درست در هر دسته و موارد اشتباه را ثبت کنید. برای پاسخ متنی، علاوه بر رعایت قالب، درستی محتوا و حذف یا اضافهشدن اطلاعات مهم را انسان بررسی کند. امتیاز کلی خوب نباید خطای مهم یک گروه از درخواستها را پنهان کند. زمان پاسخ را هم فقط با دستگاه، مدل و شرایط همان اجرا گزارش کنید؛ عددی برای همه سیستمها وجود ندارد.
اگر پس از شخصیسازی، پاسخهای تازه بدتر شدهاند یا مدل بیش از حد یک مثال را تکرار میکند، به داده، دستور و روش برگردید. افزودن نمونه بیشتر بدون پیداکردن علت خطا، راهحل قابلاتکایی نیست.
Dataset Studio در HSTOCK AI HUB چه کاری انجام میدهد؟
تفاوت نسخهها: صفحه رسمی دریافت دستی HSTOCK AI HUB نسخه ۰٫۷۳٫۳۹ را عرضه میکند. راهنمای Dataset Studio در این بخش بر پایهٔ کد نسخهٔ پیشانتشار ویندوز ۰٫۷۳٫۶۲ نوشته شده است. وجود همین گزینهها یا یکسانبودن آنها در نسخهٔ عمومی ۰٫۷۳٫۳۹ تأیید نشده است. این مقاله گزارش اجرای عملی برنامه روی دستگاه کاربر نیست.
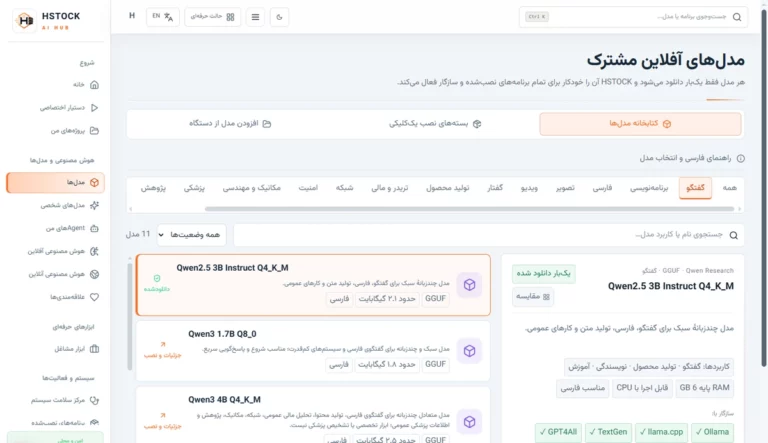
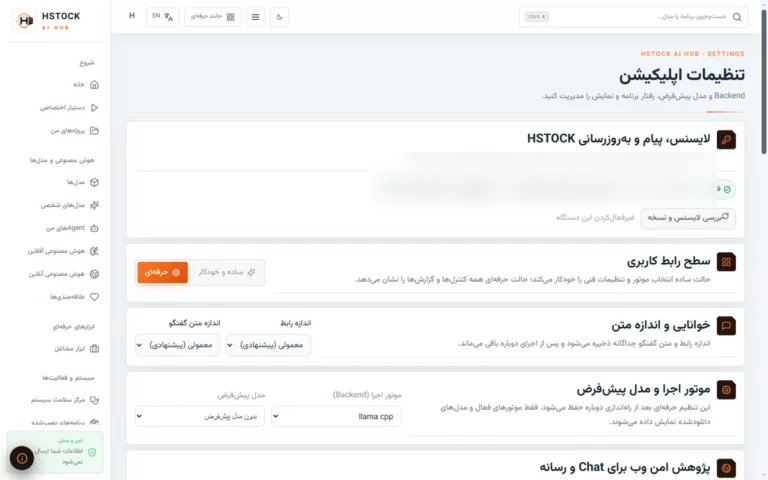
Dataset Studio در بخش «دانش اختصاصی» مدل شخصی قرار دارد. هنگام پاسخگویی، نمونههای مرتبط و تأییدشده را در اختیار مدل میگذارد؛ وزنهای مدل را آموزش نمیدهد. برای آشنایی با مسیر کلی برنامه، میتوانید به معرفی امکانات HSTOCK AI HUB مراجعه کنید.
- در مدل شخصی موردنظر، بخش «دانش اختصاصی» و سپس Dataset Studio را باز کنید؛ ساخت مدل و آمادهکردن موتور، مرحلهای جدا از ورود داده است.
- با «نمونه جدید» یک درخواست، «زمینه اختیاری» و «نمونه پاسخ مطلوب» ثبت کنید؛ برای فایل آماده از «ورود فایل» استفاده کنید.
- نمونههای تکراری، موارد نامعتبر و تعارضها را بررسی کنید. برای درخواست و زمینه یکسان، پاسخ ناسازگار نیازمند تصمیم بازبین است.
- وضعیت «تأییدشده»، «نیازمند بازبینی» و «غیرفعال» را با توجه به محتوای واقعی تعیین کنید. اگر میخواهید JSONL پیش از استفاده بازبینی شود، مانند مثال بالا status را draft بگذارید؛ ورود فایل لزوماً تأیید انسانی محتوا نیست.
- «تأیید موارد تمیز» فقط موارد بدون تعارض ثبتشده را تأیید میکند؛ این دکمه درستی پاسخ را با منبع خارجی نمیسنجد. امتیاز نمایشدادهشده نیز از وضعیت تأیید و تعارض محاسبه میشود، نه از دقت مدل روی آزمون مستقل.
- کلید استفاده از Dataset در پاسخ را بررسی کنید؛ برای این مسیر، ابزار بازیابی محلی مدل شخصی نیز باید فعال باشد. سپس آزمونهای کنارگذاشتهشده را اجرا و پاسخها را بازبینی کنید.
برچسب «پاسخ-قطعی» برای پاسخدادن به سؤال مشخص به کار میرود؛ به معنی فهم همهٔ جملههای مشابه نیست. برای استفاده از پاسخ مستقیم، شرایط همان مسیر هم باید برقرار باشد. قیمت و موجودی روز یا توصیهای را که به شرایط بستگی دارد، به پاسخ ثابت تبدیل نکنید. برای نشاندادن سبک پاسخ، نمونههای متنوع و درست انتخاب کنید.
خروجی دیتاست با فایل مدل آموزشدیده فرق دارد
در نسخهٔ ۰٫۷۳٫۶۲، «خروجی JSONL» نمونههای تأییدشده و بدون تعارض را در قالب messages با نقشهای user و assistant ذخیره میکند. این فایل، مجموعه داده است؛ وزن مدل یا Adapter آموزشدیده نیست. پیش از تحویل فایل به ابزار آموزش، درخواستها، پاسخها، زمینهٔ همراه درخواست و دیگر اطلاعات نمونهها را مرور کنید.
فایل .hstockmodel کاربرد دیگری دارد: تنظیمات مدل شخصی، دانش قابلحمل و نمونههای تأییدشده را برای انتقال آماده میکند. فایل مدل پایه و فایل LoRA داخل این بسته تکرار نمیشوند. اگر میخواهید بعداً آموزش تکمیلی انجام دهید، نسخه داده، مجوزها و مجموعه آزمون را جدا نگه دارید؛ خروجیگرفتن بهخودیخود آموزش را آغاز نمیکند.
کد ۰٫۷۳٫۶۲ برای هر فایل ورودی Dataset سقف ۶۴MiB و برای تعداد رکوردها سقف ۵۰هزار را تعریف میکند. این اعداد فقط سقف نرمافزار را مشخص میکنند. تعداد نمونهٔ مناسب به کاربرد شما بستگی دارد و رعایت این سقفها عملکرد روی هر دستگاه را تضمین نمیکند.
اگر واقعاً به Fine-tuning یا LoRA نیاز داشتیم
ابتدا باید نشان دهید مشکل با دستور بهتر، داده تمیز یا بازیابی مرتبط حل نشده است. سپس ابزار آموزشی سازگار را انتخاب کنید، داده و قالب گفتوگو را آماده کنید و نتیجه را در برابر نسخه پایه بسنجید. پارامترها، فایلهای خروجی و نسخه داده باید قابلپیگیری باشند؛ کاهش خطای آموزش، بهتنهایی اثبات بهبود روی درخواست تازه نیست.
بخش بررسیشدهٔ کد HSTOCK AI HUB، اتصال یک LoRA آماده با قالب GGUF برای llama.cpp را نشان میدهد؛ حداکثر یک LoRA همزمان فعال میشود. این مسیر، ساخت یا آموزش LoRA داخل برنامه را تأیید نمیکند. فایل Adapter باید با همان مدل پایه و موتور سازگار باشد؛ پسوند GGUF بهتنهایی برای اثبات سازگاری کافی نیست. برای استفاده از نمونههای پاسخ هم نیازی به اتصال LoRA ندارید.
هزینه و سختافزار را پس از انتخاب روش بررسی کنید
بنا بر اعلام HSTOCK، خود HSTOCK AI HUB رایگان است. هزینهٔ سرویس یا API اختیاری، اینترنت و دانلود مدلها، برق، فضای ذخیرهسازی و مجوز مدل یا داده را جدا بررسی کنید. طبق کد این نسخه، استفاده از نمونههای پاسخ در مسیر محلی به API پولی مدل نیاز ندارد. بااینحال، رایگانبودن برنامه به معنی بینیازی همیشگی از اینترنت یا بررسی مجوز نیست.
برای نوشتن، پاکسازی و مرور جدول نمونهها، معمولاً میتوانید از کامپیوتر موجود شروع کنید. اجرای مدل به اندازه و قالب آن، طول ورودی و موتور وابسته است. آموزش تکمیلی بار دیگری دارد و نیاز حافظه و شتابدهنده باید برای همان مدل، روش، طول نمونه و تنظیمات بررسی شود؛ امکان اجرای یک مدل برای گفتگو، امکان آموزش آن با همان سختافزار را ثابت نمیکند.
اگر پس از اندازهگیری بار واقعی، به اجرای مشترک، ظرفیت بیشتر یا زیرساخت اختصاصی نیاز داشتید، برای خرید سرور HP گزینهها را با نیاز پروژه مقایسه کنید. خرید سرور پیشنیاز آمادهکردن دیتاست نیست. برای کارهای وابسته به GPU، سازگاری کارت، حافظه، پاور، رایزر، فضا، خنکسازی، درایور و نرمافزار باید در کانفیگ دقیق بررسی شود.
خطاهای رایج و اقدام بعدی
| مشاهده | چه چیزی را بررسی کنیم؟ |
|---|---|
| همه پاسخها شبیه یک نمونه شدهاند. | تکرار مثالها، دستور بیش از حد محدود و پوشش کم درخواستهای متفاوت را بررسی کنید. |
| روی داده آشنا خوب است، روی جمله تازه ضعیف است. | نشت داده میان مجموعهها، نمونههای بسیار مشابه و کمبود تنوع واقعی را بررسی کنید. |
| نمونه وارد شده ولی استفاده نمیشود. | وضعیت تأیید، تعارض، کلید استفاده در پاسخ، فعالبودن بازیابی محلی و ارتباط نمونه با سؤال را ببینید. |
| امتیاز Dataset بالا است ولی پاسخ غلط است. | امتیاز وضعیت داده را با ارزیابی مستقل پاسخ اشتباه نگیرید؛ پاسخ مرجع و نتیجه تولیدشده را بازبینی کنید. |
| فایل آموزشی در ابزار مقصد پذیرفته نمیشود. | ساختار هر رکورد، نام فیلدها، قالب گفتوگو، کدگذاری و محدودیت طول ابزار مقصد را کنترل کنید. |
| دانش تازه یا قیمت روز نادرست پاسخ داده میشود. | نسخه منبع و تازگی اطلاعات را بررسی کنید؛ داده متغیر را با پاسخ ثابت جایگزین نکنید. |
پرسشهای متداول
برای ساخت مدل شخصی چند نمونه لازم است؟
تعداد ثابتی برای همه کارها وجود ندارد. ابتدا نمونههایی انتخاب کنید که وضعیتهای مهم و متفاوت مسئله را پوشش دهند. با مجموعهای جدا ارزیابی کنید و داده تازه را برای خطاهای مشخص بیفزایید. سقف ورود داده در یک برنامه، معیار کافیبودن داده آموزشی نیست.
میتوانیم فایل PDF را به دیتاست تبدیل کنیم؟
میتوانید از سند مجاز، نمونه پرسشوپاسخِ بازبینیشده بسازید؛ اما استخراج متن با ساخت پاسخ مرجع یکی نیست. اگر هدف فقط پیداکردن پاسخ داخل همان اسناد است، معمولاً باید ابتدا مسیر بازیابی از فایل را بررسی کنید. این انتخاب از بازنویسی بیدلیل یک سند کامل به صدها مثال جلوگیری میکند.
آیا دادههای ما با واردکردن در Dataset Studio داخل وزن مدل ذخیره میشوند؟
در پیادهسازی بررسیشده ۰٫۷۳٫۶۲، خیر؛ نمونههای مرتبط به ورودی پاسخگویی اضافه میشوند. خروجی JSONL هم داده است. برای تغییر وزنها یا آموزش Adapter، فرایند آموزشی جداگانه و ابزار سازگار لازم است.
از کجا بفهمیم پروژه آماده استفاده است؟
وقتی معیارهای ازپیشتعریفشده را روی موارد کنارگذاشتهشده بررسی کردهاید، خطاهای مهم روشناند و نسخه مدل، داده و تنظیمات مشخص است. یک پاسخ خوب یا یک امتیاز داخلی برای پذیرش کافی نیست؛ ارزیابی باید با دامنه همان کاربرد و ریسک خطا تناسب داشته باشد.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. اولین نفر باشید.