
چگونه مدل آفلاین مناسب فارسی را انتخاب و ارزیابی کنیم؟
فهرست مطالب
- پیش از مقایسه، چهار چیز را ثابت نگه دارید
- کارت مدل را چگونه بخوانیم؟
- مجموعه پرسش فارسی خودتان را بسازید
- یک برگه امتیاز ساده و روشن
- بنچمارک فارسی چه کمکی میکند و چه کمکی نمیکند؟
- روش مقایسه مرحلهبهمرحله
- نمونه جدول ثبت نتیجه، بدون عدد ساختگی
- خطاهای رایج در انتخاب مدل فارسی
- جایگاه HSTOCK AI HUB در این روش
- چه زمانی سختافزار یا سرور قویتر لازم میشود؟
- جمعبندی
برای انتخاب مدل آفلاین مناسب فارسی، از فهرستهای «بهترین مدل» شروع نکنید. چند مدل سازگار با سختافزار و موتور خود انتخاب کنید و آنها را با پرسشهای واقعی، ثابت و غیرحساس خودتان بسنجید. دقت محتوا، پیروی از دستور، خوانایی فارسی، حفظ عدد و نام، اعلام ندانستن و تکرارپذیری را جدا امتیاز بدهید. مدلی که در یک بنچمارک عمومی بالاتر است، لزوماً برای کار شما انتخاب بهتری نیست.
مرز این راهنما: منابع رسمی Hugging Face و پژوهش PersianMMLU در ۸ نوامبر ۲۰۲۶ بررسی شدند. هیچ مدل دانلود یا اجرا نشد و هیچ نتیجهٔ سرعت، کیفیت یا مصرف حافظهای از طرف HSTOCK گزارش نمیشود. نسخهٔ عمومی ثبتشدهٔ HSTOCK AI HUB برابر ۰٫۷۳٫۳۹ است؛ سورس پیشانتشار ۰٫۷۳٫۶۲ و تصویر آرشیوی ۰٫۶۷٫۱ جدا هستند. عنوان و نام مدلهای نمونه به معنی پیشنهاد قطعی یا تضمین کیفیت فارسی نیست.
پیش از مقایسه، چهار چیز را ثابت نگه دارید
- کار: گفتوگو، خلاصهسازی، استخراج اطلاعات، بازنویسی یا پاسخ بر اساس متن؟ یک مدل ممکن است در یک کار خوب و در کار دیگر ضعیف باشد.
- گونهٔ مدل: Base، Instruct یا نسخهٔ تخصصی را با هم مخلوط نکنید. برای گفتوگو معمولاً نسخهٔ Instruct نقطه شروع مستقیمتری است.
- موتور و تنظیمات: موتور، دستور سیستمی، طول context و تنظیمات مشترک تولید را تا حد امکان و در محدودهٔ سازگاری مدلها ثابت نگه دارید. برای هر مدل از قالب گفتوگو (chat template) و نشانههای کنترلی مستند همان مدل استفاده کنید و نام یا نسخهٔ قالب و منبع آن را ثبت کنید؛ یک قالب یکسان را به مدلهای متفاوت تحمیل نکنید. اگر رابط بعضی تنظیمها را نشان نمیدهد، همان وضعیت را برای همه مدلها ثبت کنید.
- شرایط سختافزار: برنامههای پسزمینه و تعداد درخواستهای همزمان را یکسان نگه دارید. کیفیت پاسخ را با سرعت و مصرف حافظه در یک امتیاز مخلوط نکنید.
اگر میخواهید quantهای یک مدل ثابت را مقایسه کنید، راهنمای انتخاب GGUF و تفاوت Q4، Q5 و Q8 مسیر جداگانهای دارد. ابتدا خانواده و گونهٔ مناسب را پیدا کنید؛ سپس اثر quant را با همان مدل بسنجید.
کارت مدل را چگونه بخوانیم؟
راهنمای رسمی Model Cards در Hugging Face میگوید کارت مدل باید کاربرد موردنظر، محدودیتها، دادهها، پارامترهای آموزش و نتایج ارزیابی را توضیح دهد. کاملنبودن این بخشها الزاماً مدل را بیاستفاده نمیکند، اما میزان عدمقطعیت شما را بالا میبرد.
| بخش کارت مدل | سؤال عملی | مرز برداشت |
|---|---|---|
| Language | آیا فارسی صریحاً در فهرست زبانها آمده است؟ | وجود فارسی کیفیت همهٔ سبکها و موضوعها را تضمین نمیکند؛ نبود آن نیز فقط نیاز به آزمون دقیقتر را نشان میدهد. |
| Intended uses | مدل برای چت، تکمیل متن، کد یا کار دیگری ساخته شده است؟ | استفاده خارج از دامنه میتواند نتیجه متفاوتی بدهد. |
| Limitations | ناشر درباره خطا، سوگیری، زبان یا موضوع حساس چه گفته است؟ | فهرست محدودیتها ممکن است کامل نباشد. |
| Base model و version | این فایل نسخه پایه، fine-tune، merge یا quant کدام مدل است؟ | نام مشابه به معنی وزن و رفتار یکسان نیست. |
| Evaluation | آزمون، داده، prompt، metric و نسخه مدل مشخصاند؟ | امتیاز بدون روش و منبع، مقایسه قابلاعتماد نمیسازد. |
| License | استفاده، توزیع و کاربرد تجاری چه محدودیتی دارد؟ | مجوز موتور، مدل و دیتاست سه موضوع جدا هستند. |

مجموعه پرسش فارسی خودتان را بسازید
برای شروع، مجموعهای کوچک اما متنوع از کارهای مهم خود آماده کنید؛ این آزمون اولیه پوشش کامل یا نتیجه آماری را تضمین نمیکند. موارد را از کار واقعی خود بردارید، اما نام مشتری، شماره تماس، رمز، پرونده و متن محرمانه را با نمونهٔ ساختگی جایگزین کنید. پاسخ مطلوب یا نکات ضروری هر مورد را پیش از دیدن خروجی مدل بنویسید.
| نوع آزمون | نمونه پرسش | چه چیزی را میسنجیم؟ |
|---|---|---|
| پیروی از قالب | «پاسخ را فقط در سه مرحله شمارهدار بنویس و هر مرحله یک جمله باشد.» | رعایت تعداد، ترتیب و محدودیت پاسخ |
| درک متن | یک بند کوتاه بدهید و بپرسید: «فقط براساس این متن، شرط لغو چیست؟» | تکیه بر متن و خودداری از افزودن جزئیات |
| حفظ عدد و نام | «کد AB-204، مبلغ ۱۲۵۰۰ و تاریخ ۱۴۰۵/۰۸/۱۷ را در جدول برگردان.» | حفظ نویسه، عدد و ترتیب بدون تغییر |
| خلاصهسازی | «این متن را در دو جمله خلاصه کن و نتیجه تازه نساز.» | پوشش نکات اصلی و پرهیز از استنباط بیپشتوانه |
| بازنویسی | «این پیام را رسمی و روشن کن؛ معنی و عددها تغییر نکند.» | روانی فارسی و حفظ معنی |
| ابهام | درخواست ناقصی بدهید که یک داده ضروری کم دارد. | پرسیدن سؤال لازم بهجای حدس |
| دانش بهروز | درباره رویدادی پس از تاریخ دانش مدل بپرسید. | اعلام محدودیت؛ مدل آفلاین بدون منبع تازه نباید خبر بسازد. |
| اصطلاح تخصصی | دو اصطلاح واقعی حوزه خود را در جملهای کوتاه به کار ببرید. | فهم بافت و ترجمهنکردن نادرست نامهای تخصصی |
یک برگه امتیاز ساده و روشن
برای هر معیار از ۰ تا ۲ امتیاز بدهید: ۰ یعنی شرط اصلی رعایت نشده، ۱ یعنی بخشی درست است اما خطای قابلتوجه دارد و ۲ یعنی شرط همان مورد را برآورده کرده است. تعریف امتیاز را پیش از مقایسه بنویسید تا سلیقه بعد از دیدن نام مدل نتیجه را جابهجا نکند.
| معیار | ۰ | ۱ | ۲ |
|---|---|---|---|
| درستی نسبت به متن یا پاسخ مرجع | پاسخ اصلی غلط یا ساختهشده است. | بخشی درست است اما نکته مهمی جا افتاده یا مخدوش شده است. | نکات ضروری همان مورد درستاند. |
| پیروی از دستور | قالب یا محدودیت اصلی رعایت نشده است. | بخش مهمی رعایت شده اما خروجی نیاز به اصلاح دارد. | قالب و محدودیتهای خواستهشده رعایت شدهاند. |
| فارسی روشن | متن دشوار، گسسته یا نامفهوم است. | قابلفهم است اما عبارتهای ناهنجار یا مبهم دارد. | روان، روشن و متناسب با مخاطب است. |
| حفظ عدد و نام | عدد یا شناسه کلیدی تغییر کرده است. | بیشتر موارد درستاند اما یک خطای قابلاصلاح وجود دارد. | همه موارد ضروری بدون تغییر حفظ شدهاند. |
| مدیریت ندانستن | اطلاعات بیپشتوانه با قطعیت ساخته است. | ابهام را نشان داده اما باز هم حدس زده است. | محدودیت را گفته یا سؤال لازم را پرسیده است. |
جمع امتیاز برای مرتبسازی اولیه مفید است، اما خطای بحرانی را پنهان نکنید. اگر مدل یک عدد مالی یا شرط حقوقی را تغییر دهد، میانگین خوبِ پاسخهای دیگر آن خطا را بیاهمیت نمیکند. معیارهای حیاتی را بهصورت «باید قبول شود» جدا نگه دارید.
بنچمارک فارسی چه کمکی میکند و چه کمکی نمیکند؟
پژوهش Khayyam Challenge یا PersianMMLU مجموعهای از پرسشهای فارسی در موضوعها و سطحهای مختلف را برای ارزیابی مدلها معرفی میکند. وجود چنین بنچمارکی نشان میدهد «کیفیت فارسی» یک ویژگی تکبعدی نیست. بااینحال، پرسش چندگزینهای دانش و استدلال با خلاصهسازی قرارداد، پاسخ پشتیبانی یا حفظ لحن برند یکسان نیست.
مخزن رسمی PersianMMLU برای دیتاست، محدودیت CC ND و استفادهٔ صرفاً غیرتجاری و پژوهشی ثبت کرده است. بنابراین این مجموعه را بدون خواندن مجوز در محصول یا آزمون تجاری خود کپی نکنید. میتوانید از اصل روش الهام بگیرید و پرسشهای مجاز خودتان را بسازید.
راهنمای نتایج ارزیابی Hugging Face نیز منبع، revision، task و log ارزیابی را جزئی از نتیجه قابلردیابی میداند. امتیاز یک leaderboard را بدون نسخه، quant، prompt و چارچوب آزمون به فایل دیگری با نام مشابه نسبت ندهید.
روش مقایسه مرحلهبهمرحله
- دو یا سه مدل Instruct سازگار با موتور و حافظه دستگاه انتخاب کنید.
- نام کامل مدل، نسخه، quant، موتور و تاریخ دریافت را ثبت کنید.
- پرسشها و پاسخ مطلوب را پیش از اجرا منجمد کنید.
- هر مدل را در گفتوگوی تازه و با دستور یکسان بسنجید.
- خروجی خام را نگه دارید و بدون دیدن نام مدل امتیاز بدهید، اگر این کار برای شما عملی است.
- خطاهای بحرانی را جدا از جمع امتیاز ثبت کنید.
- آزمون را روی چند روز یا با چند بازبین تکرار کنید اگر تصمیم سازمانی مهم است؛ اختلاف نظر را پاک نکنید.
- سرعت، RAM/VRAM و پایداری را در جدول جدا ثبت کنید. برای عیبیابی حافظه از راهنمای RAM و VRAM استفاده کنید.
نمونه جدول ثبت نتیجه، بدون عدد ساختگی
| شناسه مدل | نسخه و quant | درستی | پیروی از دستور | فارسی روشن | خطای بحرانی | یادداشت |
|---|---|---|---|---|---|---|
| مدل A | پس از آزمون ثبت شود | — | — | — | — | این جدول نتیجهٔ آزمون HSTOCK نیست. |
| مدل B | پس از آزمون ثبت شود | — | — | — | — | همه شرایط باید با مدل A یکسان باشد. |
خطاهای رایج در انتخاب مدل فارسی
- رتبهبندی تحریریه یا یک پاسخ خوب را بنچمارک قطعی دانستن
- مقایسهٔ مدل Base با Instruct یا دو quant متفاوت بدون ثبت تفاوت
- دادن پرسش ساده به یک مدل و پرسش سخت به مدل دیگر
- امتیازدادن فقط به لحن روان و نادیدهگرفتن عدد یا واقعیت غلط
- استفاده از متن محرمانه برای آزمون اولیه
- نسبتدادن نتیجه یک مدل ابری به فایل محلی همنام
- انتخاب مدل بزرگتر بدون سنجش حافظه، تأخیر و نیاز واقعی
جایگاه HSTOCK AI HUB در این روش
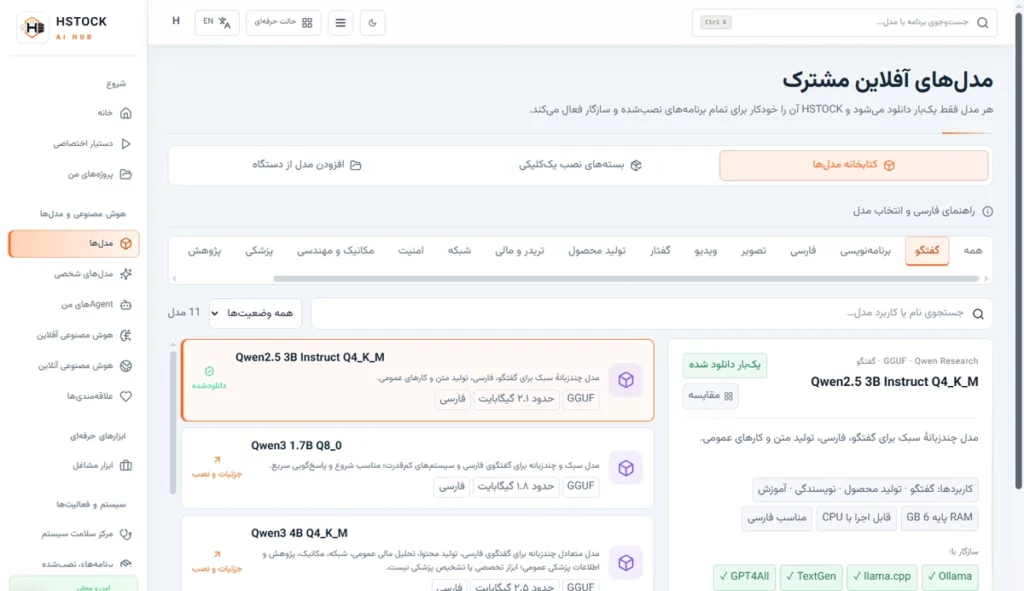
HSTOCK AI HUB میتواند محیطی برای مدیریت و اجرای مدلهای سازگار باشد، اما این مقاله کیفیت فارسی هیچ مدل را در نسخهٔ عمومی ۰٫۷۳٫۳۹ آزمایش نکرده است. تصویر کتابخانه مربوط به نسخهٔ آرشیوی ۰٫۶۷٫۱ است و مشاهده سورس پیشانتشار ۰٫۷۳٫۶۲، وجود همان کنترلها یا همان نتیجه را در نسخه عمومی ثابت نمیکند. برای یک نمونه مشخص از محدودیت زبان و راهاندازی، راهنمای اجرای Llama محلی را بخوانید؛ همان صفحه نیز کیفیت فارسی را تضمین نمیکند.
چه زمانی سختافزار یا سرور قویتر لازم میشود؟
برای مقایسه مدلهای سبک، یک رایانه شخصی سازگار میتواند کافی باشد و خرید سرور شرط ارزیابی فارسی نیست. وقتی مدل بزرگتر، چند کاربر همزمان، context طولانی یا اجرای متمرکز سازمانی لازم است، ظرفیت RAM/VRAM، توان، خنککاری و دسترسی کاربران مهم میشود. برای بررسی سختافزار رکمونت میتوانید دستهٔ سرورهای HP را ببینید، اما هر کانفیگ سرور برای هر GPU یا مدل مناسب نیست.
جمعبندی
مدل مناسب فارسی مدلی است که در شرایط سختافزار و موتور شما، روی کار واقعی شما خطاهای مهم کمتری دارد. کارت مدل و بنچمارک نقطه شروعاند، نه حکم نهایی. پرسشهای ثابت بسازید، پاسخ مطلوب را از قبل مشخص کنید، معیارها را جدا امتیاز بدهید و خطاهای بحرانی را پشت میانگین پنهان نکنید. نتیجه را همراه نسخه، quant، موتور و تاریخ نگه دارید تا مقایسه بعدی معنی داشته باشد.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. اولین نفر باشید.