
اجرای مدل زبانی با CPU در ویندوز با HSTOCK AI HUB
فهرست مطالب
اگر کامپیوتر ویندوزی شما کارت گرافیک مجزا ندارد، میتوانید گفتوگو با یک مدل زبانی محلی را روی پردازنده امتحان کنید. برای شروع، یک فایل مدل سازگار، یک موتور آماده و یک درخواست کوتاه انتخاب کنید. در نسخههایی از HSTOCK AI HUB که این مسیر محلی را دارند، میتوانید وضعیت موتور را بررسی کنید، مدل را انتخاب کنید و پاسخ را در همان رابط بخوانید.
هدف این تمرین گرفتن یک پاسخ درست از یک متن ساختگی است. زمان پاسخ، مصرف حافظه و دقت را روی دستگاه خودتان ثبت کنید تا بفهمید این مسیر برای کار روزمرهٔ شما مناسب است.
اول یک کار سبک برای آزمایش انتخاب کنید
خلاصهکردن دو خط، فهرستکردن سه کار یا استخراج تاریخ از یک متن کوتاه نقطهٔ شروع خوبی است. اگر همین درخواست ساده دیر جواب میگیرد یا سیستم کند میشود، بار اول سراغ فایل طولانی نروید. برای چنین آزمایش کوتاهی میتوانید از کامپیوتر شخصی خودتان شروع کنید.
نام مدل و اندازهٔ فایل تنها بخشی از تصمیم هستند. ورودی طولانی، طول پاسخ و کارهای همزمان هم روی تجربهٔ شما اثر دارند. برای شروع، مدل سبکتر سازگار را انتخاب کنید و ورودی را کوتاه نگه دارید.
۱. HSTOCK AI HUB و موتور محلی را آماده کنید
- برای دریافت برنامه، صفحهٔ دریافت نسخهٔ ۰٫۷۳٫۳۹ HSTOCK AI HUB را باز کنید. آمادهکردن فایلها، نصب و بررسی نسخه را از راهنمای دانلود هوش مصنوعی آفلاین برای ویندوز دنبال کنید.
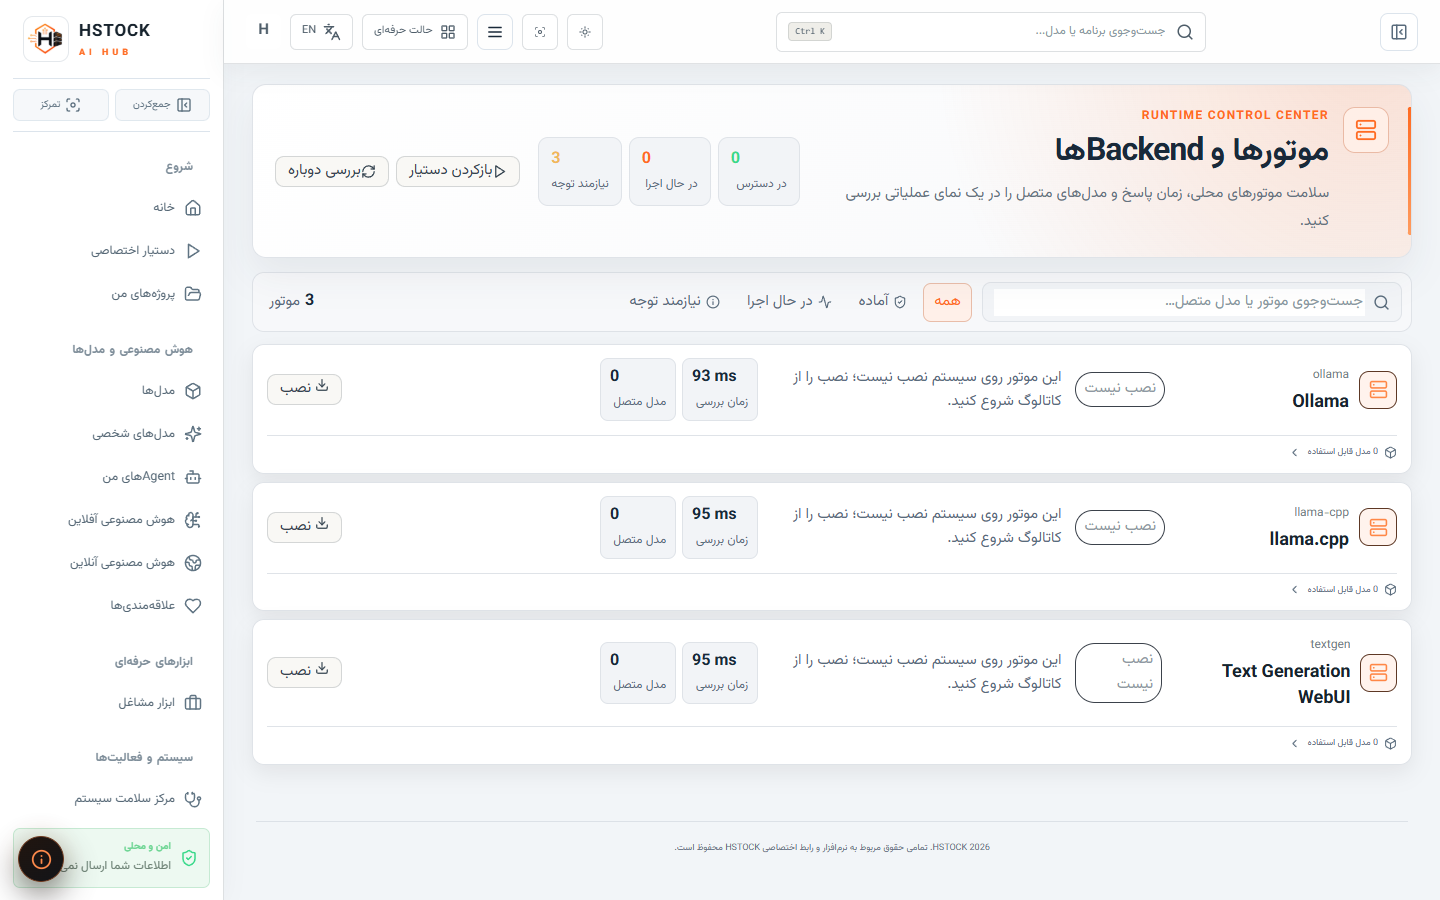
- وضعیت موتور موردنظر را در بخش هوش مصنوعی آفلاین بررسی کنید. نام بخشها بر پایهٔ نسخههای آرشیوی و بررسی کد پیشانتشار ۰٫۷۳٫۶۲ است. این مسیر بهصورت عملی در نسخهٔ دانلودی ۰٫۷۳٫۳۹ تأیید نشده است. برای
llama.cpp، دستور آمادهسازی موتور و سازگاری ساخت آن را با پردازنده و ویندوز خود بررسی کنید. - وقتی موتور آماده شد، سراغ مدل بروید. نصب برنامه، آمادهکردن موتور و دریافت مدل سه مرحلهٔ جدا هستند. برای دریافت اولیهٔ فایلها و بررسی شرایط فعالسازی، مستندات نسخهٔ نصبشده را بخوانید.
۲. یک فایل GGUF سازگار انتخاب کنید
GGUF قالب فایل مدل است. هنگام انتخاب، نام مدل و گونهٔ آن را کامل ثبت کنید. برای بازکردن فایل، معماری مدل باید با موتور سازگار باشد. اگر فایل را قبلاً تهیه کردهاید، در نسخهای که واردکردن مدل را پشتیبانی میکند از بخش مدلها مسیر «افزودن مدل از دستگاه» را بررسی کنید. برای کاربرد تجاری، مجوز همان مدل و همان فایل را بخوانید.
اگر از قبل Ollama دارید، در AI HUB همان موتوری را انتخاب کنید که مدل را واقعاً فهرست میکند. راهنمای نصب Ollama و آمادهسازی اولین مدل مسیر مستقل آن را هم توضیح میدهد. اگر انتخاب شما از خانوادهٔ Llama است، راهنمای اجرای Llama روی کامپیوتر به انتخاب نسخه کمک میکند.

۳. اولین گفتوگو را با پاسخ قابل بررسی اجرا کنید
در گفتوگوی تازه، موتور و نام کامل مدل را انتخاب کنید. اگر میخواهید اجرای کامل روی CPU را بسنجید، قبل از ارسال از نسخهٔ مخصوص CPU موتور یا تنظیم مستند اجرای بدون GPU استفاده کنید. در این آزمون وب و ابزارهای اختیاری را خاموش بگذارید. این متن ساختگی را برای مدل بفرستید.
لیلا سهشنبه ساعت ۱۰ جلسه دارد. گزارش را باید دوشنبه تا ساعت ۱۶ تحویل دهد. این دو کار را در دو خط و به ترتیب زمان بنویس.
پاسخ را با ورودی مقایسه کنید. تحویل گزارش باید قبل از جلسه بیاید و ساعتها باید همان ۱۶ و ۱۰ بمانند. اگر مدل تاریخ یا ساعت میسازد، پاسخ را برای کار واقعی کنار بگذارید و کیفیت مدل را با دو تمرین کوتاه دیگر بررسی کنید.
برای مقایسهٔ دو مدل، متن، موتور و تنظیمات را ثابت نگه دارید و هر بار گفتوگوی تازه باز کنید. از لحظهٔ ارسال تا ظاهرشدن اولین متن و سپس تا پایان پاسخ زمان بگیرید. این مقایسه برای همین سیستم و همین کار معنا دارد.
۴. مشخص کنید بار پردازش روی کدام بخش دستگاه است
در Task Manager ویندوز، همزمان با اجرای آزمون، مصرف پردازنده و حافظه را ببینید. ممکن است موتور در یک فرایند جدا از رابط برنامه اجرا شود. وضعیت پردازندهٔ گرافیکی را هم نگاه کنید، حتی اگر دستگاه تنها گرافیک یکپارچه دارد.
در گزارش موتور برای همان اجرا، دستگاه پردازش و هر نوع واگذاری کار به GPU، از جمله بارگذاری لایههای مدل، را بررسی کنید. نمودار مصرف دستگاه فقط نشانهای کمکی است. اگر گزارش موتور مشخص نمیکند پردازش کجا انجام شده، نتیجه را «مسیر پردازش تأیید نشد» ثبت کنید. مستندات پروژهٔ llama.cpp مسیرهای پردازنده و پردازندهٔ گرافیکی را توضیح میدهد.
اگر مدل باز نشد یا پاسخ خیلی کند بود
| نشانه | اول این مورد را بررسی کنید | آزمون بعدی |
|---|---|---|
| مدل در فهرست ظاهر نمیشود | نام فایل، کاملبودن آن و موتور انتخابشده | ببینید همان موتور مدل را شناسایی میکند و سپس فهرست رابط را دوباره بخوانید. |
| مدل هنگام بازشدن خطا میدهد | سازگاری معماری مدل و حافظهٔ آزاد | یک مدل سبکتر سازگار را با ورودی کوتاه امتحان کنید. |
| شروع پاسخ دیر است | آمادهشدن مدل در اجرای اول، برنامههای باز و طول ورودی | پس از آمادهشدن مدل، دو اجرای تازه با ورودی یکسان ثبت کنید. |
| پاسخ عدد یا زمان را تغییر میدهد | دقت همان مدل روی متن کوتاه شما | یک متن ساختگی دیگر با جواب معلوم امتحان کنید و موارد اشتباه را بشمارید. |
برای پیدا کردن خطای بازشدن مدل، با یک فایل سالم مقایسه کنید
یک مدل سبک را که قبلاً روی همین موتور و در حالت CPU پاسخ داده است، بهعنوان مرجع انتخاب کنید. در یک گفتوگوی تازه از آن بخواهید فقط واژهٔ «آماده» را بنویسد. سپس همین درخواست را با مدل تازه امتحان کنید. موتور، حالت پردازش و برنامههای باز را تا حد ممکن یکسان نگه دارید و پیش از هر نوبت، طبق مستندات موتور مطمئن شوید اجرای مدل قبلی پایان یافته است.
کنار نام کامل هر مدل بنویسید کار در کدام مرحله متوقف شد. بررسی کنید فایل در فهرست هست یا نه. اگر در فهرست بود، ببینید در مرحلهٔ بازشدن متوقف میشود یا پس از فرستادن درخواست بیپاسخ میماند. اگر هر دو مدل به یک شکل خطا میدهند، اول وضعیت موتور و منابع دستگاه را بررسی کنید. اگر مدل مرجع پاسخ میدهد، بررسی را از فایل تازه و شرایط بازشدن همان فایل شروع کنید.
برای نمونه، فرض کنید مدل مرجع «آماده» را مینویسد و مدل تازه هنگام بازشدن خطای حافظه میدهد. حافظهٔ آزاد را درست قبل از بازکردن مدل ببینید و یک گونهٔ سبکتر و سازگار از همان مدل را امتحان کنید. اگر پیام موتور به معماری پشتیبانینشده اشاره دارد، نسخهٔ موتور و معماری فایل را با مستندات تطبیق دهید. پاسخ «آماده» فقط نشان میدهد این درخواست کوتاه کامل شده است. کیفیت مدل را بعد با کاری که واقعاً میخواهید انجام دهید بسنجید.
کندیِ شروع پاسخ را چطور جدا بررسی کنیم؟
همان سؤالِ گزارش و جلسه را در دو گفتوگوی تازه بفرستید. بار اول سؤال را به همان شکل بفرستید. بار دوم یک بند ساختگیِ بیارتباط پیش از سؤال بگذارید و دوباره همان جواب دوخطی را بخواهید. فایل مدل، موتور و تنظیمات را ثابت نگه دارید و آزمون را وقتی شروع کنید که مدل آمادهٔ پاسخ است.
برای هر نوبت دو زمان جدا بنویسید. یکی از لحظهٔ ارسال تا رسیدن اولین کلمه و دیگری از اولین کلمه تا کاملشدن جواب. دو جواب را هم بررسی کنید تا ترتیب کارها و ساعتها درست مانده باشند و مدل هر دو بار تقریباً به یک اندازه نوشته باشد.
اگر تفاوت در چند بار تکرار شد و فقط شروع پاسخِ ورودی بلندتر دیرتر بود، برای کار روزمره اول بخشهای بیربط ورودی را کوتاه کنید. اگر شروع پاسخ تقریباً یکسان است ولی نوشتن جواب در هر دو نوبت طول میکشد، درخواست جواب کوتاهتر را جداگانه با همان ورودی امتحان کنید. نتیجه را برای همان فایل، موتور و دستگاه ثبت کنید.
این مسیر چه زمانی برای کار شما کافی است؟
برای یک نفر و چند درخواست کوتاه، مزیت AI HUB این است که بررسی موتور، انتخاب مدل و گفتوگو را کنار هم دارید. اگر پاسخها بهموقع و قابلاعتمادند، همان آزمون را با متنی شبیه کار روزانهتان تکرار کنید. اجرای یک مدل محلی آماده میتواند بدون API پولی مدل انجام شود. هزینهٔ سرویسهای اختیاری و شرایط مجوز مدل جداگانه بررسی میشوند.
برای چند کاربر همزمان، اسناد بلند یا اجرای پیوسته، ابتدا اندازهٔ کار واقعی را ثبت کنید. تعداد کاربران، طول ورودی، حافظهٔ آزاد و زمان قابلقبول پاسخ، مبنای انتخاب دستگاهاند. اگر بعد از آزمون به زیرساخت سازمانی نیاز داشتید، دستهٔ خرید سرور HP را برای بررسی مدلها و ظرفیت ارتقای آنها ببینید.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. اولین نفر باشید.