
راهنمای انتخاب فایل GGUF و کوانتیزه؛ Q4، Q5 یا Q8؟
فهرست مطالب
- GGUF چیست و چه چیزی را ثابت نمیکند؟
- نام فایل GGUF را چگونه بخوانیم؟
- Q4، Q5، Q6 و Q8 چه تفاوتی دارند؟
- مدل کوچکتر یا quant پایینتر؟
- چکلیست سازگاری پیش از دانلود
- اجرای GGUF در llama.cpp
- ورود GGUF به Ollama
- ورود مدل در HSTOCK AI HUB چه مرزی دارد؟
- خطاهای رایج GGUF و معنی احتمالی آنها
- یک مثال تصمیمگیری بدون عددسازی
- آیا برای GGUF به سرور نیاز داریم؟
- جمعبندی
GGUF قالب فایل مدل برای اجرا با موتورهای خانوادهٔ GGML مانند llama.cpp است؛ Q4، Q5 یا Q8 نوع کوانتیزه را نشان میدهد. عدد کمتر معمولاً فایل و مصرف حافظهٔ وزنها را کاهش میدهد، اما میتواند افت بیشتری در کیفیت ایجاد کند. انتخاب درست فقط از روی «Q4» انجام نمیشود: مدل پایه، اندازهٔ پارامتر، نوع دقیق quant، معماری، chat template، مجوز و سازگاری موتور باید با هم بررسی شوند.
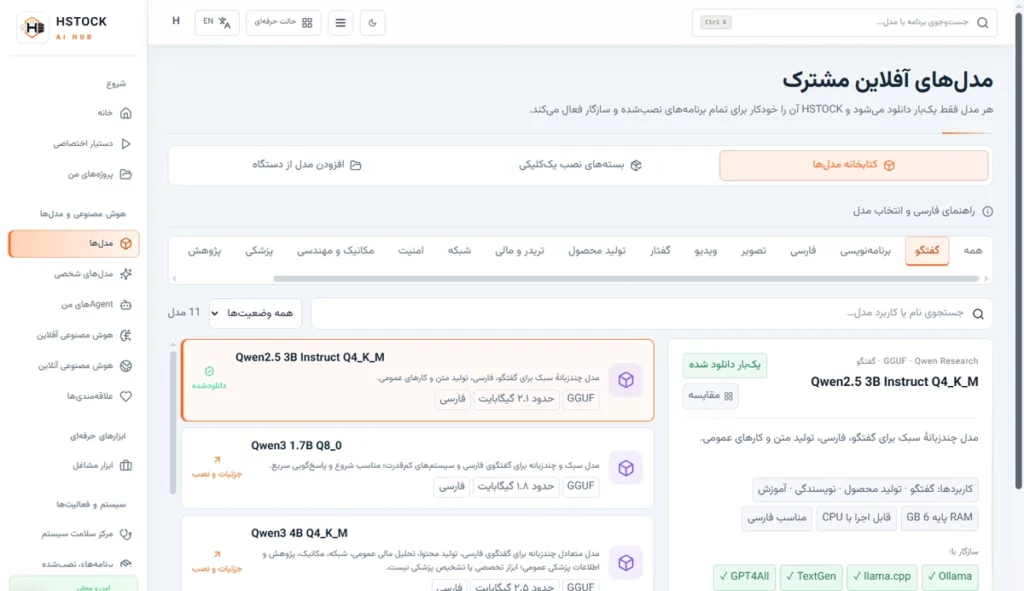
دامنهٔ این راهنما: منابع رسمی GGUF، llama.cpp، Ollama و Hugging Face در ۸ نوامبر ۲۰۲۶ بررسی شدند. هیچ فایل مدلی دانلود، تبدیل، quantize یا اجرا نشد. سورس پیشانتشار HSTOCK AI HUB ۰٫۷۳٫۶۲ مسیر عمومی ورود GGUF دارد، اما این مشاهده برابری با نسخهٔ عمومی ۰٫۷۳٫۳۹ یا سازگاری هر GGUF را ثابت نمیکند. تصویر پایین واقعی اما آرشیوی و مربوط به نسخهٔ ۰٫۶۷٫۱ است.
GGUF چیست و چه چیزی را ثابت نمیکند؟
مشخصات رسمی GGUF آن را قالبی برای ذخیرهٔ مدلهای استنتاج با GGML و اجراکنندههای سازگار معرفی میکند. فایل میتواند tensorها و metadataهایی مانند معماری، نام مدل، quant، tokenizer و اطلاعات مجوز را نگه دارد. بااینحال، پسوند .gguf بهتنهایی این موارد را تضمین نمیکند:
- موتور شما معماری همان مدل را پشتیبانی میکند.
- فایل کامل، سالم یا از ناشر مورد اعتماد است.
- مدل برای گفتوگو تنظیم شده یا chat template درست دارد.
- کیفیت فارسی، طول زمینه یا سرعت روی دستگاه شما مناسب است.
- مجوز مدل اجازهٔ بازتوزیع یا کاربرد موردنظر را میدهد.
- فایل واحد است؛ بعضی مدلهای GGUF چند shard دارند و همهٔ بخشها لازماند.
نام فایل GGUF را چگونه بخوانیم؟
ModelName-8B-Instruct-Q4_K_M.gguf| بخش نام | معنی معمول | پرسش لازم |
|---|---|---|
| ModelName | خانواده یا نام مدل | منبع رسمی و نسخهٔ دقیق چیست؟ |
| 8B | ردهٔ تقریبی تعداد پارامترها | آیا dense است یا MoE و موتور آن را پشتیبانی میکند؟ |
| Instruct | گونهٔ تنظیمشده برای پیروی از دستور | آیا chat template و زبان موردنیاز مستند است؟ |
| Q4_K_M | نوع دقیق کوانتیزهٔ وزنها | این quant با نسخهٔ موتور و backend سازگار است؟ |
| 00001-of-00003 | بخش اول از فایل چندتکه | آیا هر سه shard با نام اصلی کنار هم هستند؟ |
نامگذاری ناشران همیشه یکدست نیست. مشخصات GGUF یک الگوی نامگذاری پیشنهاد میکند، اما تصمیم را با model card، صفحهٔ فایل و metadata تطبیق دهید. تغییر نام یا پسوند، مدل را به معماری یا quant دیگری تبدیل نمیکند.

Q4، Q5، Q6 و Q8 چه تفاوتی دارند؟
کوانتیزه دقت عددی وزنها را کم میکند تا فایل کوچکتر شود و استنتاج حافظهٔ کمتری بخواهد. مستند رسمی quantize در llama.cpp صریحاً میگوید این کار میتواند افت دقت ایجاد کند. اندازه و افت ثبتشده در جدولهای آن برای مدل و روش آزمون همان جدول است؛ نباید درصد یا سرعت یک مدل را به همهٔ مدلها تعمیم داد.
| ردهٔ رایج | جهت کلی اندازه و حافظه | جهت کلی حفظ دقت وزنها | کاربرد تصمیمگیری |
|---|---|---|---|
| F16 یا BF16 | بزرگترین در این مقایسه | بالاتر؛ بدون کاهش چندبیتی وزنها | وقتی حافظه کافی و نیاز مشخص به نسخهٔ پردقت دارید. |
| Q8_0 | بزرگتر از Q6/Q5/Q4 | معمولاً نزدیکتر به نسخهٔ پردقت | وقتی حافظه بیشتر دارید و میخواهید افت ناشی از quant محدودتر باشد. |
| Q6_K | میانهٔ رو به بزرگ | بیشتر از Q4 و معمولاً بیشتر از Q5 | گزینهٔ میانی برای مقایسه، نه انتخاب قطعی همهٔ کارها. |
| Q5_K_M | میانه | معمولاً بیشتر از Q4 همان مدل | وقتی Q8 جا نمیشود اما برای پاسخهای حساستر میخواهید Q4 را با گزینهای بزرگتر مقایسه کنید. |
| Q4_K_M | کوچکتر از Q5/Q6/Q8 همان مدل | افت بیشتری ممکن است دیده شود | نامزد آزمون برای محدودیت حافظه؛ «بهترین تعادل» برای همهٔ مدلها تضمین نیست. |
| Q3 یا Q2 | کوچکتر | ریسک افت بیشتر | وقتی محدودیت حافظه شدید است و نتیجه با آزمون واقعی کار شما پذیرفتنی باشد. |
پسوند کامل مهم است. Q4_0 با Q4_K_M یکی نیست و حرفهای S، M یا L نیز بخشی از روش quant هستند، نه نشان کیفیت قطعی. مرجع GGUF در Hugging Face انواع quant را جدا فهرست میکند؛ از یک عدد کوتاه دربارهٔ همهٔ آنها نتیجه نگیرید.
مدل کوچکتر یا quant پایینتر؟
این دو تصمیم یکی نیستند. مدل ۳B با Q8 و مدل ۸B با Q4 تعداد پارامتر و رفتار متفاوت دارند؛ فقط حجم فایل را مقایسه نکنید. روش عملی این است که ابتدا کوچکترین خانوادهای را که کار شما را واقعاً انجام میدهد انتخاب کنید، سپس quantهای همان مدل و همان گونه را مقایسه کنید.
- کار را دقیق بنویسید: گفتوگو، کدنویسی، خلاصهسازی، زبان فارسی یا استفاده از ابزار. مدل عمومی را فقط بهخاطر نام مشهور انتخاب نکنید.
- یک نسخه و گونهٔ ثابت انتخاب کنید؛ مثلاً همان مدل Instruct. Base و Instruct یا نسلهای متفاوت را در آزمون quant با هم مخلوط نکنید.
- از میان فایلهای همان ناشر یا quantizer مستند، دو گزینهٔ نزدیک مانند Q4_K_M و Q5_K_M را انتخاب کنید.
- ابتدا گزینهای را امتحان کنید که همراه context لازم و فضای آزاد موتور جا میشود. اندازهٔ فایل کف تقریبی وزنهاست، نه تضمین RAM/VRAM زمان اجرا.
- با مجموعهٔ سؤال ثابت، پیروی از دستور، خطای واقعی کار و کیفیت فارسی را مقایسه کنید. یک پاسخ خوب یا بد نتیجهٔ قطعی همهٔ کاربردها نیست.
چکلیست سازگاری پیش از دانلود
| بررسی | چرا مهم است؟ | شاهد قابل قبول |
|---|---|---|
| موتور و نسخه | هر معماری یا quant در هر نسخه پشتیبانی نمیشود. | مستند رسمی موتور یا فهرست معماریهای همان نسخه |
| معماری | GGUF میتواند معماریهای متفاوتی داشته باشد. | model card و metadata مانند general.architecture |
| گونهٔ مدل | Base، Instruct و مدل تخصصی هدف یکسان ندارند. | نام کامل و توضیح ناشر |
| Tokenizer و chat template | قالب اشتباه میتواند پاسخ عجیب یا توقف نامناسب بسازد. | صفحهٔ مدل، metadata و نمونهٔ رسمی اجرا |
| Quant دقیق | Q4_0 و Q4_K_M دو فایل متفاوتاند. | نام فایل، metadata و توضیح quantizer |
| Shard یا mmproj | فایل ناقص یا مدل چندرسانهای ممکن است جزء جدا بخواهد. | همهٔ بخشهای فهرستشده در صفحهٔ مدل |
| مجوز و منبع | مجوز موتور با مجوز مدل یکی نیست. | model card، متن مجوز و ناشر قابل شناسایی |
| هش و اندازه | دانلود ناقص میتواند به خطای بارگذاری شبیه باشد. | هش یا اندازهٔ منتشرشده برای همان فایل و revision |
اجرای GGUF در llama.cpp
مستند رسمی مدلها در llama.cpp میگوید این موتور مدل را در قالب GGUF میخواهد. برای فایل محلی، نمونهٔ پایه به شکل زیر است؛ نام فایل باید با مسیر واقعی خودتان جایگزین شود:
llama-cli -m .\models\ModelName-8B-Instruct-Q4_K_M.gguf -p "در سه جمله خودت را معرفی کن."این فرمان در این مقاله اجرا نشده است و نام binary یا گزینهها میتواند با build و سیستمعامل شما فرق کند. اگر فایل چندتکه است، مستند رسمی gguf-split نحوهٔ split و merge را توضیح میدهد؛ حذف یا تغییر نام یک shard میتواند بارگذاری را خراب کند.
برای انتقال مدل به رایانهٔ بدون اینترنت، همهٔ فایلهای لازم و بخشهای GGUF را با نامهای اصلی در یک بستهٔ کامل و قابلحمل نگه دارید. راهنمای انتقال و پشتیبانگیری مدل آفلاین آمادهسازی این بسته و مقایسهٔ هش SHA-256 هر فایل پیش و پس از انتقال را توضیح میدهد.
ورود GGUF به Ollama
راهنمای رسمی Import در Ollama تأکید میکند Ollama هنگام import، فایل GGUF را quantize نمیکند؛ فایل باید از قبل آماده باشد. برای یک فایل واحد، Modelfile ساده چنین ساختاری دارد:
FROM C:\models\ModelName-8B-Instruct-Q4_K_M.ggufollama create my-local-model -f .\Modelfile
ollama run my-local-modelبرای مدل split باید نام اصلی shardها حفظ شود و الگوی FROM همهٔ بخشها را پوشش دهد. ساختن نام محلی در Ollama، مجوز مدل را تغییر نمیدهد و نتیجهٔ موفق آن در Ollama نیز شناسایی همان مدل در نسخهٔ HSTOCK AI HUB را ثابت نمیکند. برای نصب و وضعیت موتور، راهنمای Ollama در Windows را ببینید.
ورود مدل در HSTOCK AI HUB چه مرزی دارد؟
در بررسی ایستای سورس پیشانتشار ۰٫۷۳٫۶۲، مسیر عمومی افزودن فایل GGUF و فعالسازی برای موتور سازگار وجود داشت. این موضوع فقط وجود مسیر کد را نشان میدهد. برای مدل شما هنوز باید معماری، quant، مجوز، موتور نصبشده و بارگذاری واقعی تأیید شوند. صفحهٔ عمومی ۰٫۷۳٫۳۹ و تصویر آرشیوی ۰٫۶۷٫۱ وجود همان کنترلها یا نتیجهٔ import را ثابت نمیکنند. برای آشنایی با یک مدل مشخص، راهنمای انتخاب و اجرای Llama را جدا بخوانید.
خطاهای رایج GGUF و معنی احتمالی آنها
| نشانه | معنی احتمالی | اقدام بعدی |
|---|---|---|
| فایل باز نمیشود یا magic نامعتبر است | دانلود ناقص است یا فایل واقعاً GGUF نیست. | اندازه و هش همان revision را بررسی کنید؛ پسوند را دستی عوض نکنید. |
| معماری پشتیبانی نمیشود | موتور یا build قدیمی است یا این معماری را ندارد. | فهرست پشتیبانی نسخهٔ موتور را بخوانید؛ quant دیگر معماری را عوض نمیکند. |
| tensor یا shard پیدا نمیشود | یکی از بخشها کم است یا نام shard تغییر کرده است. | همهٔ فایلهای مجموعه را با نام اصلی در یک مسیر قرار دهید. |
| مدل بارگذاری میشود ولی پاسخ نامنظم است | chat template، tokenizer، گونهٔ Base یا quant بسیار فشرده میتواند عامل باشد. | template رسمی و همان مدل Instruct را بررسی و با quant بزرگتر مقایسه کنید. |
| Out of memory | وزنها همراه context و cache در حافظهٔ آزاد جا نمیشوند. | context، همزمانی، مدل یا quant را مرحلهای کاهش دهید؛ فایل کوچکتر تنها عامل نیست. |
| مدل تصویری یا صوتی فقط متن میبیند | projector یا جزء چندرسانهای جدا آماده نشده است. | صفحهٔ مدل و مستند موتور را برای فایل mmproj یا جزء لازم بخوانید. |
یک مثال تصمیمگیری بدون عددسازی
فرض کنید از یک مدل Instruct دقیق، فایلهای Q4_K_M، Q5_K_M و Q8_0 منتشر شدهاند. ابتدا مدل، نسخه، ناشر و مجوز را ثابت نگه دارید. اگر Q8 همراه context لازم جا نمیشود، Q5 را با همان پنج سؤال واقعی امتحان کنید؛ اگر باز هم حافظه کافی نیست، Q4 را بسنجید. نتیجه را روی پیروی از دستور، پاسخ فارسی و خطاهای کار خودتان ثبت کنید. این یک روش مقایسه است، نه گزارش آزمون این مقاله و نه تضمین اینکه Q4 یا Q8 برای همه بهتر است.
آیا برای GGUF به سرور نیاز داریم؟
برای مدل کوچک و یک کاربر، کامپیوتر شخصی مناسب میتواند کافی باشد و خرید سرور شرط استفاده از GGUF نیست. وقتی مدلهای بزرگتر، چند کاربر همزمان، نگهداری متمرکز یا GPUهای متعدد لازم است، باید RAM، VRAM، توان، خنککاری و محدودیت مجوز همان مدل اندازهگیری شود. برای سناریوی رکمونت میتوانید دستهٔ خرید سرور HP را بررسی کنید، اما سازگاری نهایی به GPU، رایزر، پاور، درایور و موتور دقیق وابسته است.
جمعبندی
انتخاب GGUF با سه سؤال شروع میشود: آیا مدل درست است، آیا موتور معماری و quant را میپذیرد و آیا فایل همراه context لازم در حافظه جا میشود؟ Q4، Q5 و Q8 فقط یکی از لایههای تصمیماند. مدل پایه، گونهٔ Instruct، chat template، shardها، مجوز و منبع فایل را ثابت کنید و quantها را با آزمون یکسان مقایسه کنید. برای آمادهسازی عمومی موتور و مدل نیز راهنمای دانلود هوش مصنوعی آفلاین در ویندوز را بخوانید.
دیدگاهها
هنوز دیدگاهی ثبت نشده است. اولین نفر باشید.